В этом выпуске разбираются несколько актуальных случаев применения нейросетей в научных целях. Вместо простого перечисления того, что читатель и так найдет поисковиком, мы решили поставить вопрос: где обученная нейросеть встроена в работу так, что без нее выполнить задачу невозможно, и где «ИИ» — просто вывеска, под которой находится обычная статистическая модель?
Примеры применения ИИ, о которых пойдет речь, можно разделить на несколько групп. Во-первых, приборы и большие установки: это нанопоровый секвенатор, обсерватория имени Веры Рубин и Большой адронный коллайдер, на которых события и оповещения фильтруют с помощью машинного обучения. Применяется этот подход и в работе с сейсмическими каталогами, в наблюдении радиовсплесков, в обнаружении гравитационных волн, в детекторах нейтрино, в изучении плазмы токамака. Вторая группа — инструменты, вросшие в повседневную работу и использующиеся для моделирования структуры белков (AlphaFold), расчета межатомных потенциалов, прогноза погоды, чтения маммограмм, криоэлектронной микроскопии. Наконец, третий случай — новое и спорное. Сгенерированные геномы фагов, расшифрованные свитки Геркуланума, спроектированные белки, успехи в олимпиадной математике, новые материалы и лекарства, статьи, написанные с помощью ИИ, неожиданное поведение агентов при испытаниях. Подробно рассказать о сути всех этих методов в рамках одной статьи невозможно, но если хочется разобраться — смотрите список литературы (он в веб-версии).
Случаи сгруппированы по ответу на вопрос, что случится, если изъять модель из рабочего процесса.
Под словом «модель» будем подразумевать обученный на данных алгоритм: нейросеть, случайный лес, градиентный бустинг. Что это такое и где граница с байесовской оптимизацией, сказано в «Шпаргалке». В пересказах всё это регулярно зовут «искусственным интеллектом», и на этой подмене держится половина недоразумений, поэтому дальше мы каждый раз называем метод.
Шпаргалка
Обученная модель — алгоритм, параметры которого подобраны по данным, а не выведены из теории.
Сверточная сеть — архитектура для данных с локальной структурой: изображений, сигналов.
Графовая нейросеть — работает с объектами и связями между ними: например, межатомные расстояния, частицы в струе.
Случайный лес — ансамбль решающих деревьев (экспертных алгоритмов, обученных на разных массивах данных). Это обучаемый метод, но не нейросеть. В пересказах его тоже зовут «ИИ».
Байесовская оптимизация — способ искать максимум «дорогой» функции за малое число проб. Подстраивается по собственным пробам в ходе поиска, а не по внешнему обучающему корпусу.
Экспертная система — программа, основанная на составленных вручную правилах. К обучаемым методам не относится.
Расчет функционала плотности — стандартный квантовый способ считать силы между атомами. Эталон, на котором учат потенциалы.
Межатомный потенциал — функция, дающая энергию и силы взаимодействия по положениям атомов.
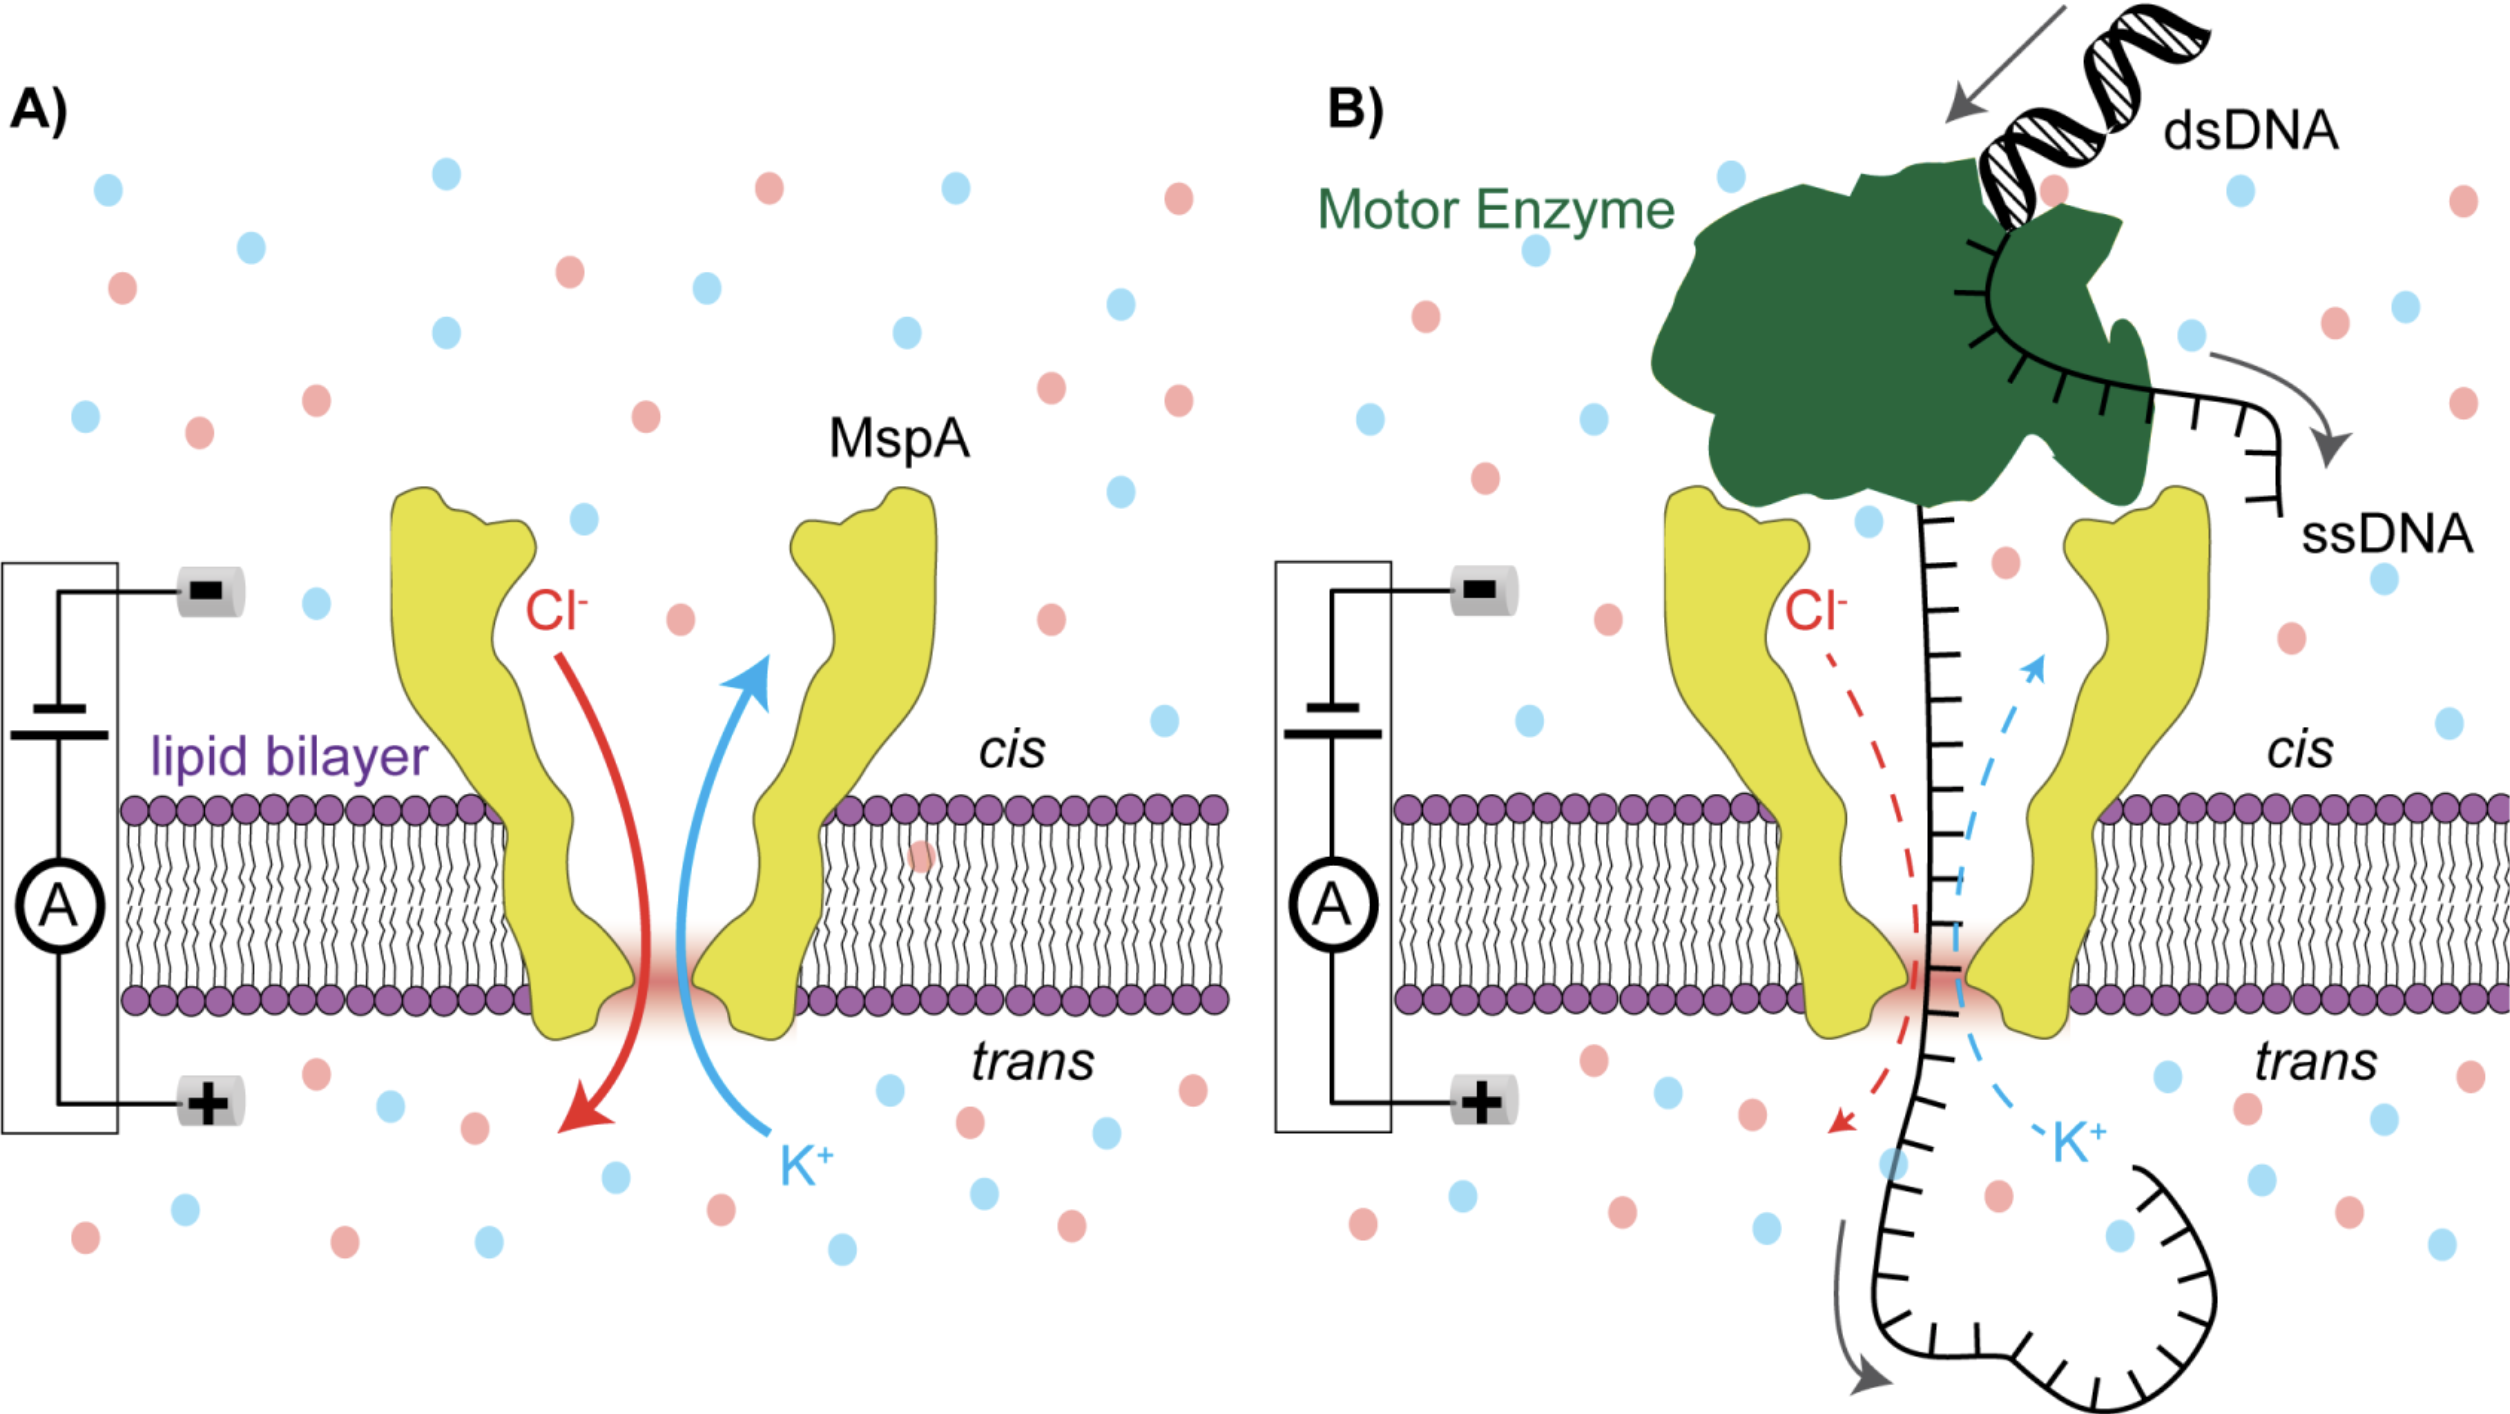
Нанопоровый секвенатор — прибор для расшифровки генетического кода, который пропускает молекулы ДНК/РНК через микроскопические поры и измеряет изменения электрического тока.
Доклиника — стадия до испытаний на людях. Фазы 1, 2, 3 — испытания на людях, от безопасности к эффективности.
Воспроизводимость — возможность независимо повторить работу. Для сервисных моделей ограничена: отключили версию — точный повтор невозможен.
Коротко о результатах. Из разобранных примеров не может работать без ИИ только один прибор: современный нанопоровый секвенатор. Без вычислительного декодера он выдает электрический ток, который слишком зашумлен, чтобы его интерпретировать как буквы генетического кода. Близко к нему стоит чтение обугленных свитков из Геркуланума, но там томограф выдает продукт, с которым можно работать, — карту плотности, и без сетей теряется не сигнал, а его прочтение. Там, где результатом является научное утверждение, последнее слово осталось за человеком. В разобранных здесь случаях анализируется только решение конкретных задач, а не весь путь от вопроса до результата.
Выключи — и работа встанет
Нанопоровый секвенатор протягивает цепь ДНК через белковую пору и выдает на выходе колебания ионного тока, а не буквы нуклеотидов. Перевод одного в другое, basecalling, с 2017 года делает нейросеть [1]. Отказ от вычислительных декодеров делает прибор неработоспособным. Незаменима здесь не именно нейросеть — до нее ток читали скрытыми марковскими моделями. Медианная точность распознавания нуклеотидов нейросетевого декодера в лучшем из рассмотренных режимов составляет 99,93% [2].
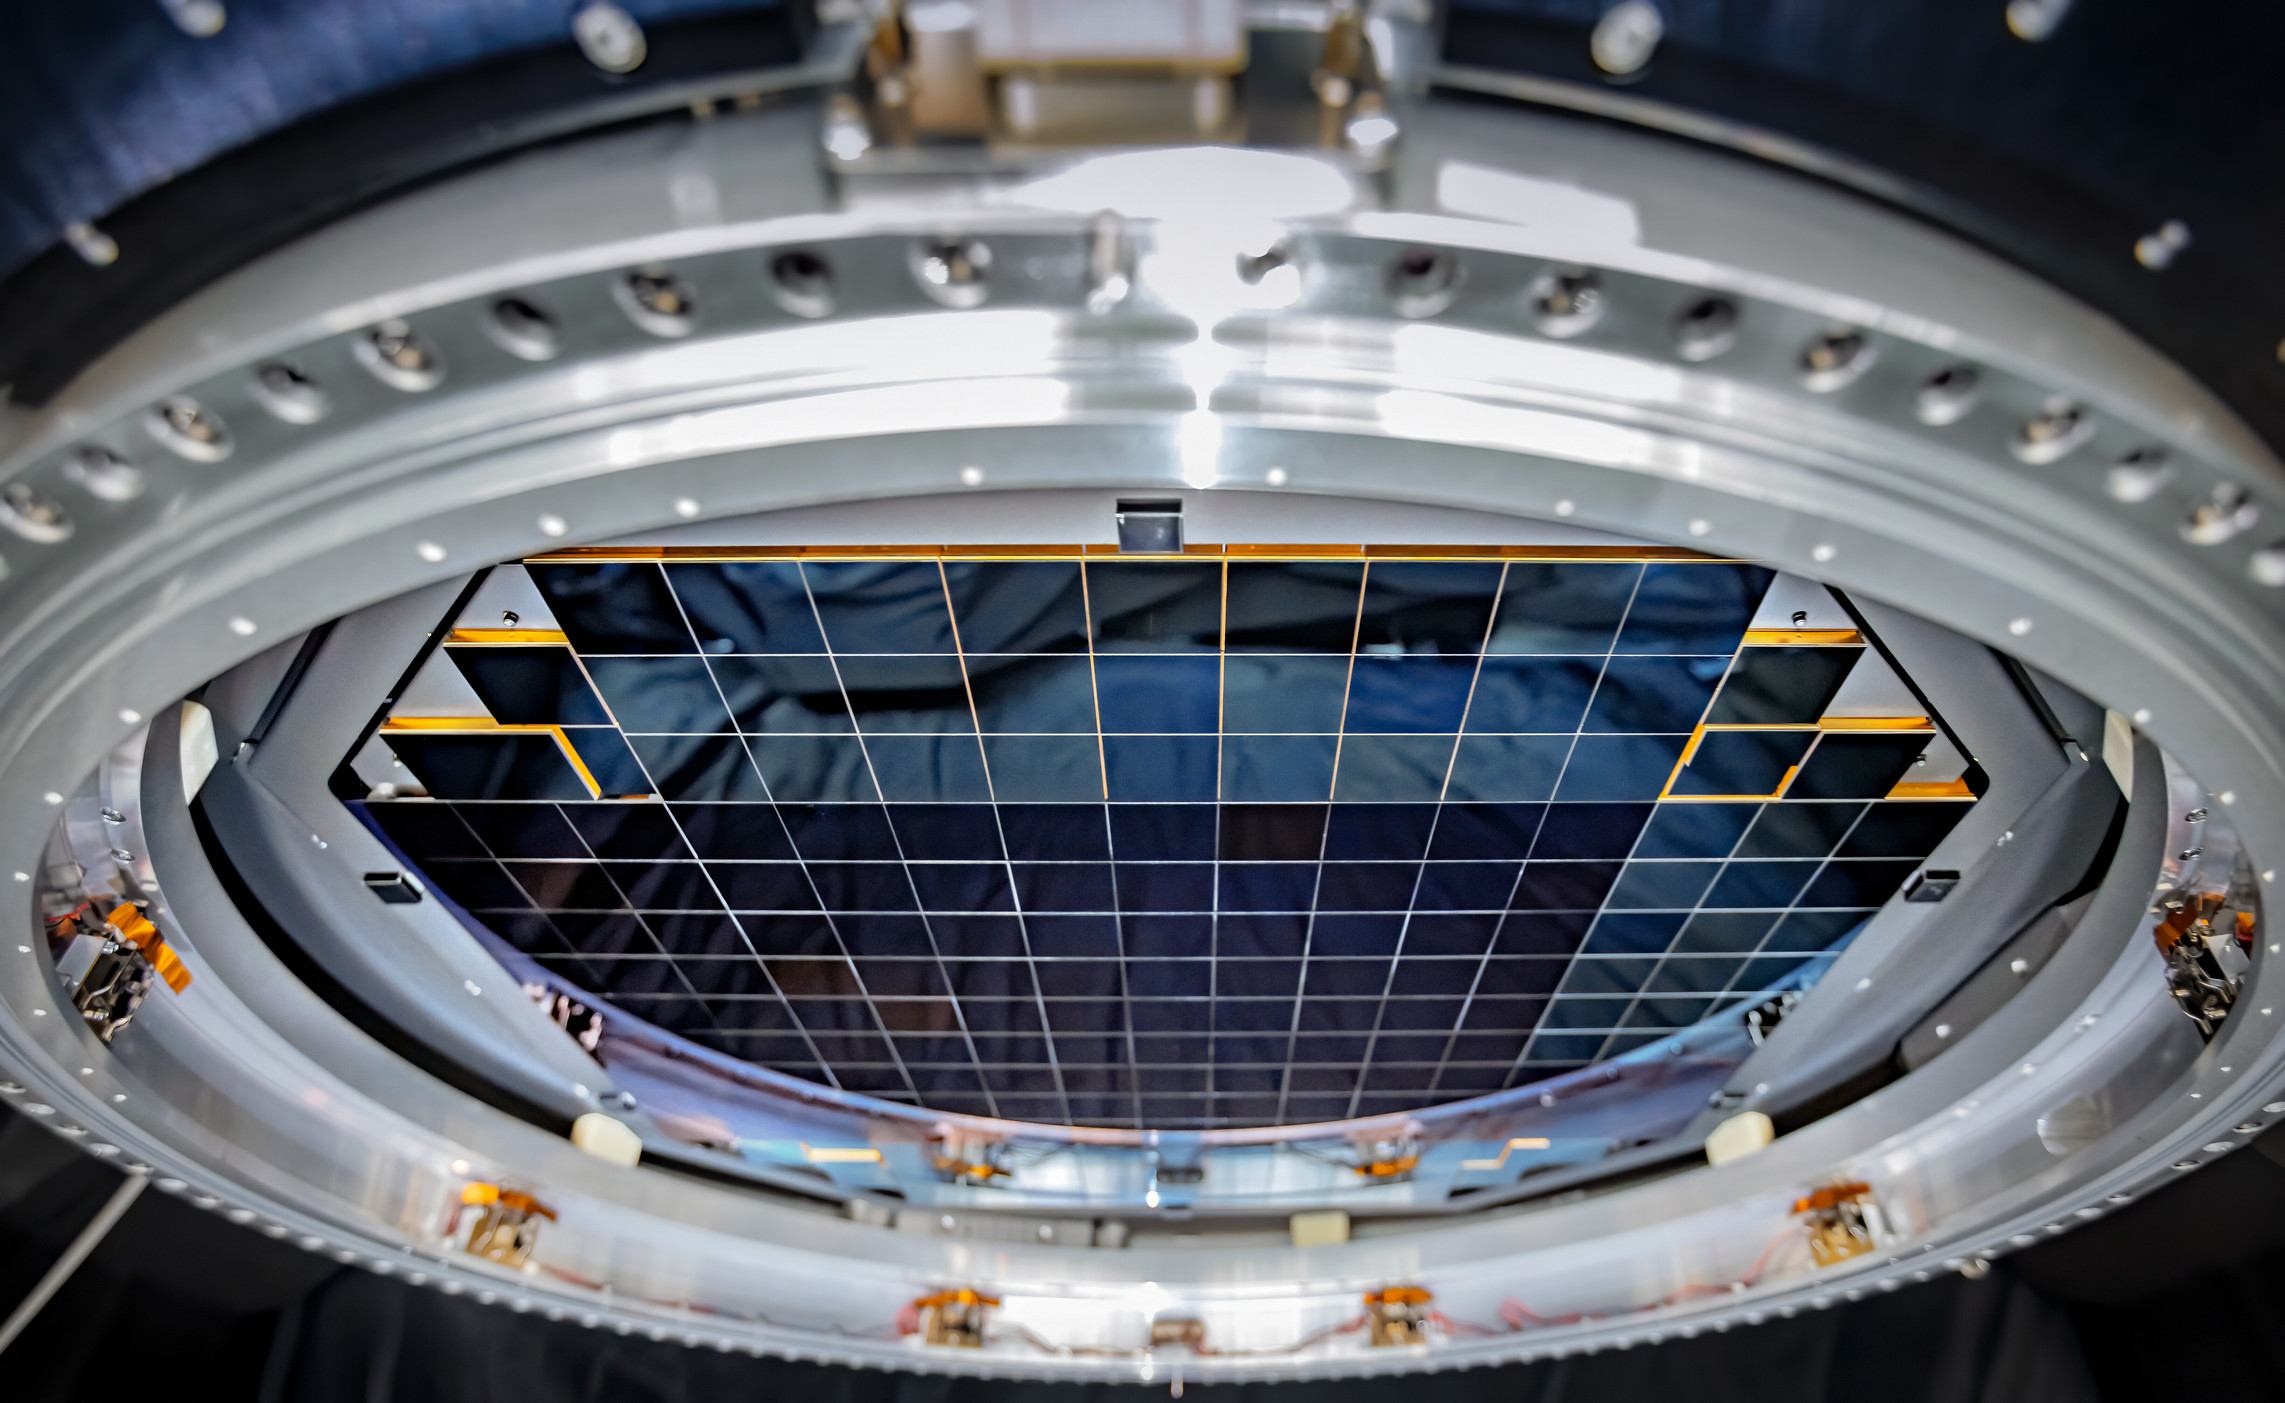
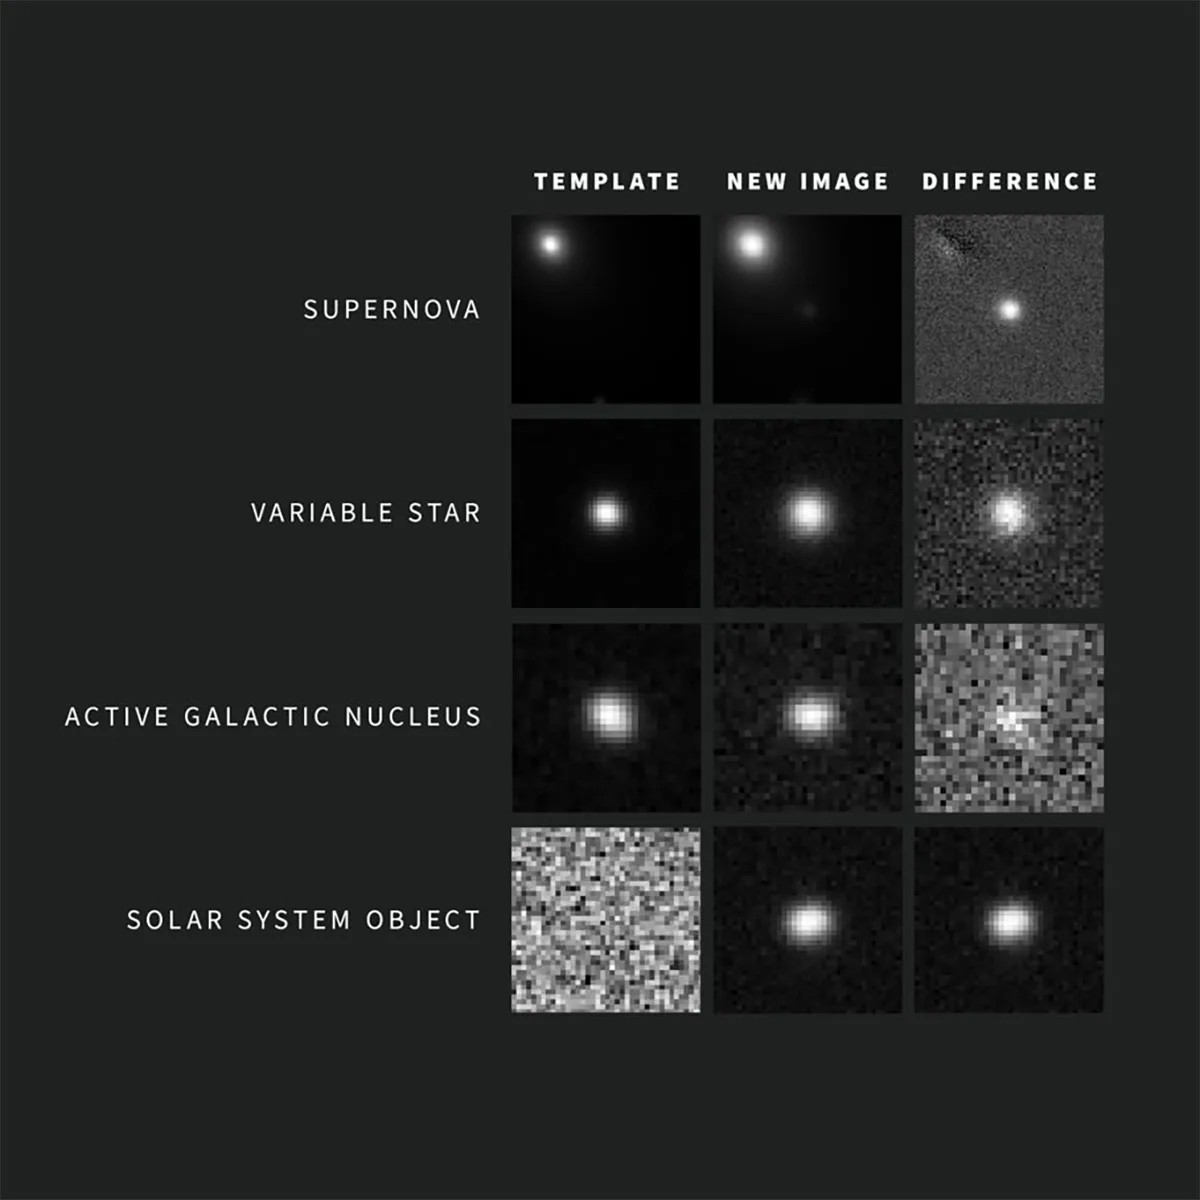
Близки по степени важности нейросетей и обзорные телескопы. Они рассылают за ночь столько оповещений об изменениях неба, что на все человек реагировать не в состоянии. Так, обсерватория имени Веры Рубин за первую ночь своей работы, 24 февраля 2026 года, разослала 800 тыс. публичных оповещений [3]. Это была только пусконаладка, а в рабочем режиме она рассылает до семи миллионов за ночь [57]. Разбирают поток автоматические «брокеры», основанные на разных методах: в системе ALeRCE фрагменты снимков, содержащие возможные события, классифицирует сверточная сеть, а кривые блеска — сбалансированный случайный лес, к нейросетям отношения не имеющий [4]. Без «брокера» телескоп не ослепнет, и данные будут копиться, но прекратится отбор целей в реальном времени, пока событие не погасло. Стало быть, не будет вовремя принято решение о том, куда навести дефицитные большие телескопы.
Столь же критично применение ИИ и в работе с данными Большого адронного коллайдера. Пучки частиц там сталкиваются 40 млн раз в секунду, и записать всё невозможно, данные хранятся только в усеченном виде. Поэтому событие, не отобранное онлайн, полностью восстановить нельзя. С 2022 года часть пороговых алгоритмов на программных шагах отбора в CMS заменена обучаемыми: тау-лептоны сначала размечал классификатор DeepTau, а с 2025 года его в триггере сменили модели на основе графовой сети ParticleNet [5]. Автоэнкодеры (системы фильтрации данных) AXOL1TL и CICADA развернуты прямо в железе еще в 2024 году, и за тот год они отобрали на хранение более 4 млрд событий [6]. Заменить обучаемый отбор пороговым можно: он станет хуже, но не прекратится.
В основе составления сейсмического каталога — списка землетрясений со временем и координатами — лежит еще один рутинный процесс: на записи каждой станции надо отметить момент прихода волны, «вступление». Десятилетиями это делал человек, и его производительность определяла, сколько событий попадет в каталог. Сеть PhaseNet расставляет вступления по каждому отсчету записи [7]. Масштаб виден по каталогу зоны субдукции (места, где одна литосферная плита погружается под другую) в Атакаме: 6,7 млн «вступлений», сопоставленных с событиями, дали более 166 тыс. событий [9]. Дальше применяются классические методы сейсмологии, однако нейросети проникли и в другие задачи. Так, в работе по Центральным Апеннинам ИИ определяет еще и полярности первых вступлений, т. е. входные данные отбирает и обрабатывает нейросеть, а сами движения подземных пород рассчитывает классический алгоритм [8]. В подобных задачах актуальны и классические методы: так, каталог Южной Калифорнии на 1,81 млн землетрясений, который в 2019 году увеличил число известных событий региона на порядок, получен вообще без нейросетей — сопоставлением с шаблонами [10]. Такие примеры иногда ошибочно приписывают ИИ. (Уточним: землетрясения PhaseNet не предсказывает, авторы метода этого и не заявляли…)
Остальные случаи с большими потоками данных укладываются в один абзац. При детектировании гравитационных волн для отбора сигналов и определения параметров источников используются в основном классические алгоритмы. Однако в одном из пяти конвейеров обработки данных каталога GWTC-4.0 вердикт обученного ИИ-классификатора был задействован непосредственно при отборе кандидатов [58]. При наблюдении быстрых радиовсплесков (FRB) на канадском телескопе CHIME события «ловит» классическая дедисперсия (восстановление сигнала после «размытия») с порогами, а обучаемый ИИ занимается чисткой помех. Хотя есть примеры использования нейросетей при классификации кандидатов для ряда телескопов и в этом направлении [73]. Рекордное нейтрино KM3NeT реконструировано методом максимального правдоподобия, и его энергия — около 220 ПэВ при 90-процентном интервале от 72 ПэВ до 2,6 ЭэВ [59]. Управление плазмой обучением с подкреплением показано на токамаке TCV в Лозанне [74], но рутинного штатного режима добиться не удалось. Ни в одном из этих случаев обучаемый компонент не стал основой для детектирования или реконструирования сигнала, итоговый результат везде дает классический метод.
Три вопроса к любой новости про ИИ в науке
Чтобы понять, ИИ ли это, достаточно задать три вопроса.
Какой именно метод? Под вывеской «искусственный интеллект» могут находиться нейросети разных архитектур, случайные леса, байесовская оптимизация, экспертные системы и обычная статистика. От ответа зависит всё остальное.
Кто проверял, кроме авторов? Рецензирование проверяет рассуждение, а не результат. Независимое воспроизведение — другая процедура, и часто ее нет.
Как далеко дошло? Расчет, пробирка, животные, люди — четыре стадии, и успех на первой не обещает последней. Доклинику нужно называть доклиникой.
Что будет, если убрать алгоритм
Вторая группа случаев устроена иначе. Здесь работу можно делать по-старому, и она не остановится, но изменится другое — цена, скорость и механизм принятия решения на выходе.
Самый яркий пример — AlphaFold2, метод предсказания пространственной структуры белка по последовательности. Над этой задачей структурная биология билась полвека. AlphaFold2 не решил ее в привычном смысле слова, но превратил отдельное дорогое вычисление в обращение к справочнику: создана база предсказанных структур, более 214 млн записей на 2023 год, которая стала неотъемлемой частью мировых ресурсов по биоинформатике — UniProt, InterPro, Ensembl, PDB (банк белковых структур) [16]. Незаменимость здесь особого рода: выключение модели не уничтожит уже посчитанную базу, но остановится ее обновление. По-прежнему важны и экспериментальные методы: кристаллография, ЯМР и электронная микроскопия как и раньше определяют структуру там, где предсказание ненадежно [16].
Родственный инструмент AlphaMissense оценивает патогенность аминокислотных замен [17], и клиническая рабочая группа, независимая от разработчиков, перекалибровала его строже, чем предлагали авторы [18].
Следующая задача из этой группы — моделирование движения атомов, для которого нужно знать действующие между атомами силы. Стандартный способ это сделать — квантовый расчет функционала плотности: он приближенный, но достаточно точный, чтобы служить эталоном при обучении, и очень дорогой. ИИ-обучение заменяет расчет потенциала предсказанием, при этом точность остается близкой, а стоимость (на графических ускорителях) — почти как для традиционных расчетов по упрощенным формулам (классическим потенциалам) [12]. Это интерполяция по уже посчитанному, и работает она только внутри обученной области, а за ее пределами может выдавать физически бессмысленные результаты. Что дает такая замена, видно по рекорду — посчитана молекулярная динамика для системы из 113 млн атомов меди [13] — это задача, которая с квантовым расчетом сил не решается вовсе [61].
Численный прогноз погоды появился раньше, чем сами компьютеры. Первую попытку сделал Льюис Фрай Ричардсон в годы Первой мировой, служа водителем в квакерском санитарном отряде на Западном фронте. Расчеты он делал вручную, на арифмометрах, в паузах между поездками за ранеными. На шестичасовой ретроспективный прогноз у него ушло почти шесть недель, при этом, согласно его расчетам, давление должно было вырасти на 145 гектопаскалей (109 мм рт. ст., изменение катастрофического масштаба), тогда как барометр почти не шелохнулся. В книге 1922 года Ричардсон описал «фабрику прогнозов»: зал с картой мира на стенах, в нём — 64 тыс. людей-вычислителей, призванных «обгонять» погоду [70]. Сегодня прогноз погоды — область, где обученная модель работает в оперативном режиме и ее продукт ежедневно доходит до миллионов людей. Европейский центр среднесрочных прогнозов ввел модель AIFS в оперативную работу в 2025 году, вторая версия работает с мая 2026 года, 15-суточный прогноз она считает за минуты и тратит примерно в тысячу раз меньше энергии, чем предыдущая [22]. AIFS не заменила классическую модель: та работает параллельно и, что важнее, дает данные для обучения и задания начальных условий ИИ-модели. Выключите классическую систему — остановится и AIFS, но не наоборот. Гибрид NeuralGCM показывает то же еще нагляднее: под вывеской «ИИ предсказывает климат» там физическое ядро, у которого обучаемый блок заменяет подсеточную часть [24].
Следующая область, где ИИ и классические методы идут рука об руку, — криоэлектронная микроскопия. Сеть Topaz находит частицы на зашумленных снимках, ModelAngelo строит атомную модель по карте плотности [19, 20], а в световой микроскопии Cellpose сегментирует клетки [21]. Байесовская рамка трехмерной реконструкции устояла, но с 2024 года в сам цикл уточнения встроен обучаемый регуляризатор, нейросеть-шумоподавитель [60], — т. е. модель отвечает уже не только за подготовительные этапы. Незаменимой ее и здесь назвать нельзя: картинка с нейросетевым шумоподавлением выглядит правдоподобно, но это не гарантирует ее соответствия реальности — нужен отбор по шаблонам и ручная правка.
С использованием ИИ в медицине тоже пока двойственная картина. Так, в Швеции было проведено рандомизированное испытание результатов маммографии. 105 934 женщины на плановом скрининге случайно распределили между обычным двойным чтением снимков и исследованием с ИИ [26]. Промежуточный анализ на 80 033 участницах вышел в 2023 году и показал снижение нагрузки на чтение снимков на 44% [25]. Результаты опубликованы в январе 2026 года: было обнаружено 1,55 случая интервального рака (опухоли, найденной между обследованиями; если их меньше, то скрининг работает лучше) на тысячу против 1,76 в контрольной группе, инвазивных интервальных раков оказалось на 16% меньше [26]. Надо заметить, что сравнение производилось с двойным чтением (снимки анализируют два врача), принятым в Швеции, статистика при чтении в одиночку была бы иной.
По мировому масштабу применения ИИ в клинической практике систематических данных нет, но кое-что можно оценить. Так, по американской статистике на конец 2025 года существовало около полутора тысяч разрешений на медицинские устройства с машинным обучением, из них примерно три четверти — в радиологии [55].
Что общего у этих примеров? Там, где результат становится научным утверждением, последнее слово по-прежнему за людьми. Но это слово — не на входе, а на выходе. Человек не успевает за возросшим объемом информации, которую дают приборы. Узкое место науки переехало: раньше это было получение данных, теперь — проверка.
Метрика операции — не метрика результата
Частая подмена в этой теме — показатель промежуточного шага выдают за научный или клинический выигрыш.
Хорошая классификация оповещений означает не больше открытий, а лучший список целей для телескопов.
Высокое место в сводной таблице предсказания материалов не означает, что ИИ сконструировал нечто пригодное для синтеза и тем более полезное.
Снижение нагрузки на чтение снимков на 44% означает не то, что рака стали находить больше, — для этого есть отдельный показатель, и он измерялся отдельно.
Число разрешенных устройств означает число разрешений, а не их клиническую пользу.
Новое и спорное
Здесь модель предъявляет то, чего без нее не было бы под рукой: сконструированную структуру, проявленный текст, синтезированную молекулу. Проверка везде остается человеческой.
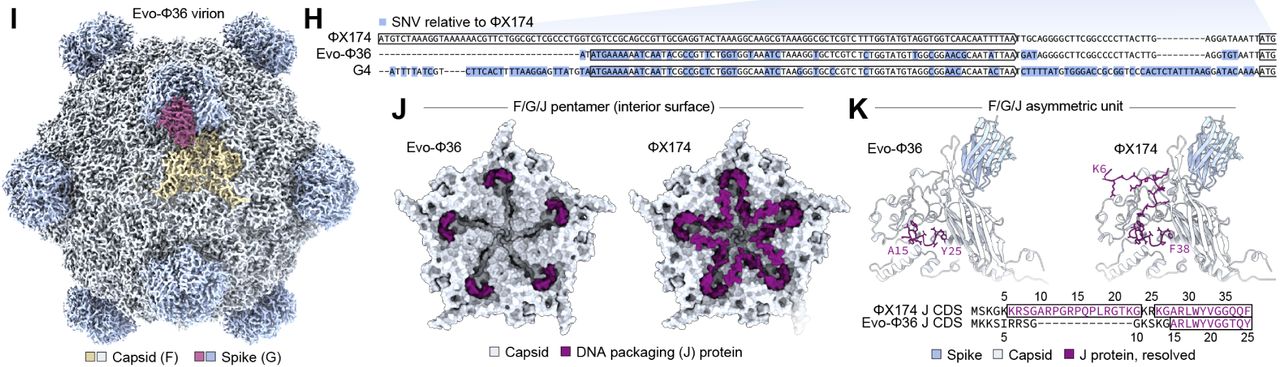
6 августа 2026 года в Science вышла работа, где геномные языковые модели Evo 1 и Evo 2 сгенерировали геномы бактериофагов, родственных вирусу ΦХ174 [30]. Из сгенерированного отобрали 302 варианта, собрали 285, жизнеспособными оказались 16. Заголовки говорили о том, что искусственный интеллект создал новую жизнь. Однако большинство отобранных кандидатов совпадают более чем на 40% с исходным вирусом и с геномами обучающей выборки, а с ближайшими природными родственниками того же семейства — на 93,0–98,8%. Речь о конструировании близкородственных объектов по шаблону, и авторы прямо об этом говорят. Работа рецензирована, однако «мокрую проверку» (лабораторные испытания) вел тот же консорциум, а независимого воспроизведения в работе нет.
В июне 2026 года был опубликован результат по полной виртуальной расшифровке одного из сохранившихся свитков Геркуланума [31]. Эти свитки — часть крупной библиотеки, пострадавшей при извержении Везувия в 79 году и обнаруженной в 1750 году при рытье колодца. Первые свитки команда Карла Вебера извлекла в октябре 1752-го. Развернуть их вручную было невозможно, поскольку они сильно обуглились. В 1753 году ватиканский хранитель рукописей Антонио Пьяджо решил создать машину, которая раскрывала свиток шелковыми нитями на грузах и винтах. Чтобы развернуть первый из свитков, ушло четыре года, а некоторые артефакты рассыпались, так и оставшись непрочитанными [71]. Нужно было найти метод, который позволит узнать, что на свитке, не повреждая его физически. Цепочка такая: синхротронная микротомография дает трехмерную карту плотности, нейросети выделяют поверхность папируса и «проявляют» чернила, а транскрибируют и интерпретируют текст восемь папирологов. Прочитанный текст предъявляет не модель, она делает его видимым. Журнального рецензирования публикации пока нет.
Выше шла речь о прогнозировании структуры белков, а вот диффузионная модель RFdiffusion конструирует белковые остовы с нуля. Можно сказать, что она «рисует» новый, не существовавший в природе белок подобно тому, как нейросети типа MidJourney генерируют картинки. Доля «удачных связывателей» (белков, выполняющих поставленные задачи — например, прикрепиться к нужному вирусу), по замерам самих авторов, — около 19% [32]. Родственный случай — сгенерированный моделью ESM3 флуоресцентный белок esmGFP, который только на 58% соответствует ближайшему флуоресцентному белку, известному в природе [33]. Флуоресцентность подтвердили авторы статьи; независимой проверки пока нет. Громкая фраза в Nature про «500 млн лет эволюции», которые удалось «перескочить» с помощью ИИ, требует поправки: никакой симуляции времени в модели нет, другое дело, что примерно столько времени нужно природе, чтобы белковые структуры разных организмов настолько разошлись. Модель же прошла это расстояние за один акт генерации.
В математике твердо установленного немного. Связка AlphaProof и AlphaGeometry решила четыре задачи из шести на Международной математической олимпиаде 2024 года, что отвечает уровню серебряной медали, и это рецензировано [34]. Сама AlphaProof справилась с тремя негеометрическими задачами из этих четырех. Дальше начинается спорное: летом 2025 года о золоте объявили несколько компаний, и процедуры проверки у них несопоставимы. Олимпиада заявила официально, что не может подтвердить ни методы, ни объем использованных вычислений, ни участие человека, ни воспроизводимость результата [64]. Слова ее президента о том, что одна из компаний набрала 35 баллов из 42, опубликованы в блоге самой этой компании, а не в официальных источниках олимпиады [69]. У другой компании решения проверяли нанятые ею медалисты, технического отчета нет, выложены только сами решения [75].
Материалы и лекарства — сюжет, где показательный пример известен, а продолжения нет. В 2023 году две работы в Nature сообщили о миллионах предсказанных неорганических кристаллических структур (различных оксидов и фосфатов) и автономной лаборатории, синтезировавшей 41 из 58 предсказанных соединений [37]. Дальше химики опубликовали предметную критику [38], а в январе 2026 года вышла авторская корректура: слово «новые» в заголовке заменено на «неорганические», один состав из 41 исключен из зачета новых, потому что уже был в обучающей выборке, а из оставшихся 40 подтверждены 36, еще четыре остались неопределенными по данным дифракции [39]. Итоговой доли успеха корректура не называет. Еще скромнее результаты генеративной модели MatterGen: из огромного массива сгенерированных ИИ вариантов выбрали как пригодные для синтеза четыре, а получить удалось только один, и тот — с множественными дефектами кристаллической структуры [40].
С лекарствами надо сразу отказаться от иллюзий: девять из десяти препаратов, дошедших до клинических испытаний, на рынок так и не вышли [41]. Дальше всего на этом пути продвинулся препарат рентосертиб, предназначенный для борьбы с идиопатическим легочным фиброзом: компания-разработчик провела испытание второй фазы на 71 пациенте с обнадеживающими результатами [42], третья фаза на 320 пациентов стартовала в июле 2026 года, новостей еще нет [62].
Наконец тексты. Если в предсказании структуры кристаллов и синтезе лекарства ИИ еще делает первые шаги, в генерации текста ИИ явно преуспел. Это касается и научных работ. Так, изучение словарного запаса более 15 млн публикаций с 2010 по 2024 год на ресурсе PubMed показало, что не менее 13,5% текста в аннотациях 2024 года написано ИИ-моделями [44]. Препринт той же лаборатории намерил по полным текстам 52% за тот же год и 89% к декабрю 2025-го [46]. Напрямую эти числа сравнивать не следует: у препринта другой оценщик и другая единица анализа. При этом автоматизация идет и со стороны чтения и анализа материалов. Программа ASReview, использующаяся при отборе литературы для обзоров, начинала на наивном байесовском классификаторе, сейчас по умолчанию работает на методе опорных векторов, а нейросети подключаются к ней расширением [63]. При этом регулирование в этой сфере пока развито слабо: как правило, научные фонды только рекомендуют раскрывать использование ИИ в подготовке заявок. А вот при рецензировании его применение в ряде научных журналов прямо запрещено [68]. Проект агентства ARPA-H, где модели сортируют и реферируют заявки, а люди принимают решение, остается единственным известным мне прецедентом допуска ИИ к оценке научных текстов [49].
И сакраментальный вопрос: а не заменит ли ИИ ученых как таковых? Громкие заявления технологических компаний о создании полноценных «ИИ-ученых» и автономных агентов сегодня активно проверяют на специализированных испытаниях-бенчмарках. Воспроизвести работу с крупной конференции лучший агент смог на 21% по замеру авторов набора [50], аспиранты на подмножестве из трех статей — на 41%, но это разные выборки. На биоинформатических вопросах с вариантами ответа модели, по отчету авторов набора, не поднялись выше случайного угадывания, а в режиме, где разрешен отказ от ответа, показали результаты ниже него [51]. Против 61 эксперта на инженерных задачах агенты вчетверо результативнее на дистанции в два часа, но на 32 часах люди уже вдвое лучше, и замеряли это на моделях конца 2024 года [52]. До нижней медальной ступени в соревнованиях по анализу данных агент не дотягивает в пяти случаях из шести [53]. Набор FrontierScience от OpenAI дал 25% на исследовательских вопросах, и сравнить эту цифру не с чем: человеческого эталона авторы не делали [54].
Что значит «незаменим»
Незаменимость бывает трех видов. Природная — где выход прибора становится нечитаемым без декодера. Экономическая — где по-старому можно, но абсурдно дорого. И мнимая: зависимость от чужого сервиса, встроенность базы в инфраструктуру, поток данных от прибора, спроектированного под модель. В третьем случае за незаменимость выдают нежелание отказываться от принятого решения — технического, организационного, коммерческого.
Обученная модель работает сегодня как расширитель: она добавляет объем, который переварит грамотный специалист, и снимает нехватку рук. Судить о том, насколько хороши эти системы, по опубликованным успехам нельзя: они не показывают, как часто попытки проваливаются.
Когда не сработало
Google Flu Trends оценивала заболеваемость гриппом по поисковым запросам. В сезон 2012–2013 годов она завышала ее более чем наполовину, на пике февраля 2013-го давала вдвое больше визитов к врачу, чем насчитала служба эпиднадзора CDC, а за два года с августа 2011-го завышала оценку в 100 неделях из 108. Разбор в Science назвал среди причин «высокомерие больших данных» (высокомерны, конечно, не данные, а исследователи, которые их получили и считают, что разбираться в их сути необязательно. — Прим. ред.) и изменение логики работы самого поисковика [27].
IBM Watson for Oncology, по обнаруженным в 2018 году внутренним документам, выдавала небезопасные рекомендации по лечению, потому что обучали ее на синтетических случаях, а не на реальных данных [56].
Epic Sepsis Model внедрен во многих больницах США. Разработчик заявлял ее показатель точности 0,76–0,83, независимая проверка на 38 тыс. госпитализаций дала 0,63, и две трети случаев сепсиса система пропустила [28].
Модели диагностики ковида по снимкам: систематический обзор 2021 года отобрал 62 работы из 2212 и заключил, что ни одна не пригодна для клиники [29].
Илья Белых
1. Wick R. R., Judd L. M., Holt K. E. Performance of neural network basecalling tools for Oxford Nanopore sequencing // Genome Biology. 2019. Vol. 20. P. 129. doi.org/10.1186/s13059-019-1727-y
2. Hall M. B. et al. Benchmarking reveals superiority of deep learning variant callers on bacterial nanopore sequence data // eLife. 2024. doi.org/10.7554/eLife.98300.3
3. Rubin Observatory Launches Real-Time Discovery Machine for Monitoring the Night Sky. 25.02.2026. rubinobservatory.org/news/first-alerts
4. Förster F. et al. The Automatic Learning for the Rapid Classification of Events (ALeRCE) Alert Broker // Astronomical Journal. 2021. Vol. 161. P. 242. doi.org/10.3847/1538-3881/abe9bc
5. Machine learning in online and offline reconstruction and identification with CMS (обзор, охватывает DeepTau, ParticleNet и замену DeepTau в триггере с 2025 года). arxiv.org/abs/2602.08010
6. CMS Collaboration. Unsupervised anomaly detection for real-time data acquisition in the CMS experiment at the Large Hadron Collider. 10.08.2026. cds.cern.ch/record/3188808
7. Zhu W., Beroza G. C. PhaseNet: a deep-neural-network-based seismic arrival-time picking method // Geophysical Journal International. 2019. Vol. 216. P. 261-273.
doi.org/10.1093/gji/ggy423
8. Meier M.-A., Lanza F., Martínez-Garzón P., Chiaraluce L. Insights into Extensional Tectonics from a Large Deep Learning Focal Mechanism Catalog // Bulletin of the Seismological Society of America. 2025. Vol. 115(6). P. 2690. doi.org/10.1785/0120250103
9. Münchmeyer J. et al. Characterizing the Atacama Segment of the Chile Subduction Margin with >165,000 Earthquakes // JGR Solid Earth. 2025. doi.org/10.1029/2025JB031256
10. Ross Z. E., Trugman D. T., Hauksson E., Shearer P. M. Searching for hidden earthquakes in Southern California // Science. 2019. Vol. 364. P. 767-771. doi.org/10.1126/science.aaw6888
12. Leimeroth N., Erhard L. C., Albe K., Rohrer J. Machine-learning interatomic potentials from a user’s perspective: a comparison of accuracy, speed and data efficiency // Modelling and Simulation in Materials Science and Engineering. 2025. Vol. 33(6). 065012. doi.org/10.1088/1361-651X/adf56d
13. Lu D. et al. 86 PFLOPS Deep Potential Molecular Dynamics simulation of 100 million atoms with ab initio accuracy // Computer Physics Communications. 2021. Vol. 259. P. 107624. doi.org/10.1016/j.cpc.2020.107624
16. Varadi M. et al. AlphaFold Protein Structure Database in 2024 // Nucleic Acids Research. 2024. Vol. 52(D1). P. D368-D375. doi.org/10.1093/nar/gkad1011
17. Cheng J. et al. Accurate proteome-wide missense variant effect prediction with AlphaMissense // Science. 2023. Vol. 381. eadg7492. doi.org/10.1126/science.adg7492
18. Bergquist T. et al. Calibration of additional computational tools expands ClinGen recommendation options for variant classification with PP3/BP4 criteria // Genetics in Medicine. 2025. Vol. 27(6). 101402. doi.org/10.1016/j.gim.2025.101402
19. Bepler T. et al. Positive-unlabeled convolutional neural networks for particle picking in cryo-electron micrographs // Nature Methods. 2019. Vol. 16. P. 1153-1160.
doi.org/10.1038/s41592-019-0575-8
20. Jamali K. et al. Automated model building and protein identification in cryo-EM maps // Nature. 2024. Vol. 628. doi.org/10.1038/s41586-024-07215-4
21. Stringer C. et al. Cellpose: a generalist algorithm for cellular segmentation // Nature Methods. 2021. Vol. 18. P. 100-106. doi.org/10.1038/s41592-020-01018-x
22. Moldovan G. et al. AIFS Single 1.1.0: an update to ECMWF’s machine-learned weather forecast model AIFS // Geoscientific Model Development. 2026. Vol. 19. P. 4703-4724. doi.org/10.5194/gmd-19-4703-2026
24. Kochkov D. et al. Neural general circulation models for weather and climate // Nature. 2024. Vol. 632. P. 1060. doi.org/10.1038/s41586-024-07744-y
25. Lång K. et al. Artificial intelligence-supported screen reading versus standard double reading in the Mammography Screening with Artificial Intelligence trial (MASAI) // The Lancet Oncology. 2023. doi.org/10.1016/S1470-2045(23)00298-X
26. Lång K. et al. // The Lancet. 2026. Vol. 407(10527). P. 505-514. doi.org/10.1016/S0140-6736(25)02464-X
27. Lazer D., Kennedy R., King G., Vespignani A. The Parable of Google Flu: Traps in Big Data Analysis // Science. 2014. Vol. 343. P. 1203-1205. doi.org/10.1126/science.1248506
28. Wong A. et al. External Validation of a Widely Implemented Proprietary Sepsis Prediction Model in Hospitalized Patients // JAMA Internal Medicine. 2021. Vol. 181(8). P. 1065. doi.org/10.1001/jamainternmed.2021.2626
29. Roberts M. et al. Common pitfalls and recommendations for using machine learning to detect and prognosticate for COVID-19 using chest radiographs and CT scans // Nature Machine Intelligence. 2021. Vol. 3. P. 199. doi.org/10.1038/s42256-021-00307-0
30. King S. H. et al. Generative design of bacteriophages with genome language models // Science. 2026. Vol. 393. eaec2657. doi.org/10.1126/science.aec2657
31. Angelotti G. et al. Complete virtual unwrapping and reading of a rolled Herculaneum papyrus. arxiv.org/abs/2606.29085
32. Watson J. L. et al. De novo design of protein structure and function with RFdiffusion // Nature. 2023. Vol. 620. P. 1089-1100. doi.org/10.1038/s41586-023-06415-8
33. Hayes T. et al. Simulating 500 million years of evolution with a language model // Science. 2025. doi.org/10.1126/science.ads0018
34. Hubert T., Mehta R., Sartran L. et al. Olympiad-level formal mathematical reasoning with reinforcement learning // Nature. 2026. Vol. 651. P. 607-613 (онлайн 12.11.2025). doi.org/10.1038/s41586-025-09833-y
37. Merchant A. et al. Scaling deep learning for materials discovery // Nature. 2023. Vol. 624. P. 80-85. doi.org/10.1038/s41586-023-06735-9; Szymanski N. J. et al. An autonomous laboratory for the accelerated synthesis of novel materials // Nature. 2023. Vol. 624. P. 86-91. doi.org/10.1038/s41586-023-06734-w
38. Leeman J. et al. Challenges in High-Throughput Inorganic Materials Prediction and Autonomous Synthesis // PRX Energy. 2024. Vol. 3. 011002. doi.org/10.1103/PRXEnergy.3.011002; Cheetham A. K., Seshadri R. Artificial Intelligence Driving Materials Discovery? // Chemistry of Materials. 2024. Vol. 36. P. 3490. doi.org/10.1021/acs.chemmater.4c00643
39. Author Correction // Nature. 2026. Vol. 650. E1. doi.org/10.1038/s41586-025-09992-y
40. Zeni C. et al. A generative model for inorganic materials design // Nature. 2025. doi.org/10.1038/s41586-025-08628-5
41. Sun D., Gao W., Hu H., Zhou S. Why 90% of clinical drug development fails and how to improve it? // Acta Pharmaceutica Sinica B. 2022. Vol. 12(7). P. 3049-3062.
doi.org/10.1016/j.apsb.2022.02.002
42. Rentosertib in idiopathic pulmonary fibrosis: a phase 2a trial // Nature Medicine. 2025. Vol. 31. P. 2602-2610. doi.org/10.1038/s41591-025-03743-2
44. Kobak D. et al. Delving into LLM-assisted writing in biomedical publications through excess vocabulary // Science Advances. 2025. doi.org/10.1126/sciadv.adt3813
46. Holzwarth L., González-Márquez R., Kobak D. Most biomedical publications show signs of LLM-assisted writing. arxiv.org/abs/2608.10715
49. ARPA-H. IGoR program statement. arpa-h.gov/explore-funding/programs/igor/statement
50. PaperBench: Evaluating AI’s Ability to Replicate AI Research. arxiv.org/abs/2504.01848
51. BixBench: a Comprehensive Benchmark for LLM-based Agents in Computational Biology. arxiv.org/abs/2503.00096
52. RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts. arxiv.org/abs/2411.15114
53. MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering. arxiv.org/abs/2410.07095
54. FrontierScience. arxiv.org/abs/2601.21165
55. FDA. Artificial Intelligence and Machine Learning (AI/ML)-Enabled Medical Devices (официальный перечень, обновляется). fda.gov/medical-devices/software-medical-device-samd/artificial-intelligence-and-machine-learning-aiml-enabled-medical-devices; FDA. Premarket Notification 510(k). fda.gov/medical-devices/premarket-submissions-selecting-and-preparing-correct-submission/premarket-notification-510k
56. Ross C., Swetlitz I. IBM’s Watson recommended ‘unsafe and incorrect’ treatments for cancer patients // STAT. 25.07.2018.
statnews.com/2018/07/25/ibm-watson-recommended-unsafe-incorrect-treatments
57. Rubin Observatory. Официальный релиз о начале десятилетнего обзора LSST. 30.06.2026. rubinobservatory.org
58. LIGO Scientific Collaboration, Virgo Collaboration, KAGRA Collaboration (Abac A. G. et al.). GWTC-4.0: Methods for Identifying and Characterizing Gravitational-wave Transients // The Astrophysical Journal Letters. 2026. Vol. 1004. P. L21. doi.org/10.3847/2041-8213/ae447b
59. KM3NeT Collaboration. Observation of an ultra-high-energy cosmic neutrino with KM3NeT // Nature. 2025. Vol. 638. P. 376-382. doi.org/10.1038/s41586-024-08543-1
60. Kimanius D., Jamali K., Wilkinson M. E., Lövestam S., Velazhahan V., Nakane T., Scheres S. H. W. Data-driven regularization lowers the size barrier of cryo-EM structure determination // Nature Methods. 2024. Vol. 21. P. 1216-1221. doi.org/10.1038/s41592-024-02304-8
61. Matbench Discovery — открытая таблица сравнения обучаемых межатомных потенциалов. matbench-discovery.materialsproject.org
62. ClinicalTrials.gov. NCT07687459: испытание третьей фазы рентосертиба, зарегистрировано 07.07.2026.
63. ASReview. Документация: модели и расширения. asreview.readthedocs.io
64. International Mathematical Olympiad. The 66th International Mathematical Olympiad draws to a close today. 19.07.2025. imo2025.au/news/the-66th-international-mathematical-olympiad-draws-to-a-close-today/
68. National Institutes of Health. NOT-OD-23-149: The Use of Generative Artificial Intelligence Technologies is Prohibited for the NIH Peer Review Process. 23.06.2023. grants.nih.gov/grants/guide/notice-files/NOT-OD-23-149.html; National Science Foundation. Notice to the research community: Use of generative artificial intelligence technology in the NSF merit review process. 14.12.2023, обновлено 21.05.2026. nsf.gov/news/notice-to-the-research-community-on-ai; Thorp H. H., Vinson V. Change to policy on the use of generative AI and large language models // Science. 16.11.2023. science.org/content/blog-post/change-policy-use-generative-ai-and-large-language-models
69. Google DeepMind. Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad. 21.07.2025.
deepmind.google/blog/advanced-version-of-gemini-with-deep-think-officially-achieves-gold-medal-standard-at-the-international-mathematical-olympiad/
70. Richardson L. F. Weather Prediction by Numerical Process. Cambridge: Cambridge University Press, 1922. P. 219 (archive.org/details/weatherpredictio00richrich); Lynch P. The origins of computer weather prediction and climate modeling // Journal of Computational Physics. 2008. Vol. 227. P. 3431-3444. doi.org/10.1016/j.jcp.2007.02.034
71. Fowler R. L. The Herculaneum Papyri // Manuscript and Text Cultures. 2024. Vol. 3(1). doi.org/10.56004/v3.1rlf; Getty Museum. Buried by Vesuvius: Treasures from the Villa dei Papiri. getty.edu/art/exhibitions/villa_papiri; Royal Society. Volcanic vistas. 2021. royalsociety.org/blog/2021/03/volcanic-vistas
72. Rubin V. C. An Interesting Voyage // Annual Review of Astronomy and Astrophysics. 2011. Vol. 49. P. 1-28. doi.org/10.1146/annurev-astro-081710-102545; Carnegie Science. Vera Rubin: Opening doors to dark matter and women in STEM. carnegiescience.edu/vera-rubin-opening-doors-dark-matter-and-women-stem
73. CHIME/FRB Collaboration. The CHIME Fast Radio Burst Project: System Overview // The Astrophysical Journal. 2018. Vol. 863. P. 48. doi.org/10.3847/1538-4357/aad188; Agarwal D. et al. FETCH: A deep-learning based classifier for fast transient classification // MNRAS. 2020. Vol. 497. P. 1661. doi.org/10.1093/mnras/staa1856
74. Degrave J. et al. Magnetic control of tokamak plasmas through deep reinforcement learning // Nature. 2022. Vol. 602. P. 414-419. doi.org/10.1038/s41586-021-04301-9
75. Wei A. Запись в X от 19.07.2025 о золотом уровне модели OpenAI на IMO 2025 и проверке решений тремя бывшими медалистами. twitter.com/alexwei_/status/1946477742855532918; решения — github.com/aw31/openai-imo-2025-proofs
В общем Юдковский поспешил) Надеюсь(
Можете не сомневаться.
Наука — не есть место для предсказаний квазифилософов (и прочих шарлатанофф).
Л.К.
Вы ее идеализируете, науку. И я отнюдь не о Петриках всяких.
Приведите конкретные примеры (чем наклеивать ярлыки чисто по-сталински! — Л.К.):
а) моей якобы идеализации науки и
в) «недопетрикофф», которые что-то такое якобы предсказали сильно научное (стихотворцы вроде Валерия Брюсова — не в счёт, как не в счёт и частотная модуляция госпожи актрисы Ламар, кажется, получившей госпатент).
Л.К.
Чем словами и фразами разбрасываться всуе.
К.
Прошу прощения, только сейчас заметил.
а. Собственно, про идеализацию — это реакция на ваше письмо непосредственно выше.
б. Cold fusion.
Некоторые так не считают, напоимер, злесь!:
https://t.me/ScInqComments/582384
Л.К.
Блестящий весьма (впрочем, по необходимости) сжатый обзор.
Имхо.
Л.К.
Всячески приветствую.
Крайне желательна (лично для меня — Л.К.) разумная периодичность (в появлении на страницах ТрВ подобных материалов). Именно этого автора — уважаемого господина Ильи Белых.
К.
Насчёт ИИ в науке, лично меня серьёзно напрягает перспектива стимулируемого им бурного размножения досужих дилетантов в таких сферах, которые раньше были доступны в основном и только спецам-профессионалам. Тенденцию к этому я наблюдаю уже сейчас. Жалко времени, которое придётся тратить всё больше и больше на выявление реальных спецов и отсеивание производимых результатов от шелухи, недоделок и псевдо-информации.
Гуманитарные науки с этим живут, и по-видимому, остальным тоже теперь придется.
«Нет, уж лучше вы к нам».
На Колыму (во всех смыслах и как бараны) не попрём!
Л.К.
Гуманитарные науки живут совсем не с этого. К ним легко прикладывается чье-то определение истории, что это просто политика, обращенная в прошлое. Или бессмертная мысль Мединского: история (сюда можно подставить любую гуманитарную науку) — это то, что мы о ней думаем.
Согласен, там часто нет возможности строгого доказательства — той самой верификации — потому теории нормально существуют параллельно друг другу.
Однако я имел в виду не научную деятельность, а скорее обычную профессиональную — как отличить спеца от профана. Исходный комментарий был как раз про это, мне кажется. Скажем, каждый может выступать в роли историка или психолога (не исследователя, а специалиста). Вот теперь и физиком может выступать каждый.
Не думаю. Слава Богу, в каждом физически значимом результате должен присутствовать так называемый физический смысл. Его наличие или отсутствие — это критерий достаточно доступный для пользования специалистами. В свое время Фейнман определил этот самый физический смысл так (близко к тексту): результат должен быть виден уже при постановке задачи.
Может, это не совсем то, о чем вы писали, но ведь обычно не людей оценивают, а результаты ими полученные.
«Смотря какой!»
Источниковедение по Данилевскому — Лаппо доставляет и весьма часто (при непременном желании, разумеется), прямые (близкие к относительно достоверным) доказательства. Без удручающего и чисто внешнего «релятивизма» (в плохом и превратном смысле).
Имхо.
Л.К.
Читайте, справясь по фамилии здесь в ТрВ по «лупе наверху» открытое письмо историка Агни к Владимиру Мединскому.
Вне рекламы (как первого, так и, особенно, второго).
К.
С Мединским всё ясно. Интересно, что вы об этом думаете. Существует некая объективная история человечества или это просто набор более-менее произвольных интерпретаций, значимость которых зависит только от текущей политики?
Есть множество исторических событий, с разной степенью достоверности и объективности зафиксированных и описанных. А история — это по сути рассказ о событиях, который может содержать, кроме прочего, интерпретации, оценки, толкования, отношения и т.п., опять же в разной степени личные или объективные (общественно-консенсусные).
Это понятно, что конкретные исторические исследования отражают субъективную точку зрения автора. Вопрос в том может ли существовать какое-то объективное историческое знание или все исследования одинаково субъективны? Физики, как мне кажется, полагают что есть таки физическая реальность независимая от наблюдателя и они к её пониманию как-то приближаются. Мединский и другие постмодернисты(?) полагают, что исторической реальности либо вообще нет, либо она совершенно непостижима.
Я бы сказал, что история содержит некий набор экспериментально установленных фактов. С погрешностями, разумеется, и с ненулевой вероятностью того, что некоторые из них представляют собой артефакты. Но для слитного изложения и анализа эти экспериментальные точки приходится аппроксимировать некими гладкими функциями. И вот тут уже открывается простор для фантазий и спекуляций.
«для слитного изложения и анализа эти экспериментальные точки приходится аппроксимировать некими гладкими функциями»
Это же ровно то, как работает ИИ ;)
Вот и «галлюцинирует» между «последоваьными узлами аппроксимации». Даваючи полную «волю» своей насквозь заёмной из датабаз (что под рукой типо) «фантазии».
Вне каких-либо научных методологических / этических установок. По принципу «если надо, то подгоним под требуемый ответ»!
Это называется квазинаучной демагогией. Но уж точно никак не нормальной наукой.
Имхо.
Л.К.
Русский источниковед Данилевский — Лаппо на Том Свете тихо ужасается. А мы на этом — громко печалимся и грустим. Ибо «железной дуре» дали не то техзаданьице.
Имхо.
К.
Физики стремятся к объективному знанию и приближаются к нему потому, что это определённо и однозначно нужно как самим физикам, так и обществу их финансирующему. В этом плане есть некий всеобщий консенсус, хотя и здесь — далеко не без девиаций. А с консенсусом по поводу необходимости выработки объективного исторического знания всё гораздо хуже.
Это правда. Но Мединский, насколько я понимаю, утверждает, что это невозможно в принципе. То есть человеческая природа не позволяет сформировать никакого приближения к объективному историческому знанию. Не мы такие — жизнь такая. Не знаю какого он мнения об ИИ (это ж не человек), но подозреваю, что и созданному людьми ИИ он в такой способности откажет.
Что утверждает Мединский я не очень в курсе, но человеческая природа действительно далеко не во всём склонна к объективизации знаний, тем паче таких неоднозначных как исторические. Общемирового консенсуса по объективной истории достичь точно невозможно, я полагаю. То, что, скажем, армяне считают геноцидом, турки таковым считать не будут.
Про консенсус, конечно, речь не идёт. Видимо, сама постановка вопроса о невозможности объективного исторического знания кажется физикам абсурдной. Мне как математику, привыкшему к парадоксам самоприменимости, вопрос не кажется совсем нелепым. Но ответ, который в частном случае означает, что выяснить был ли геноцид принципиально невозможно, кажется весьма странным.
Выяснить был ли большой взрыв тоже принципиально невозможно.
Этот вопрос упирается в определение геноцида и его трактовку.
«Согласно Конвенции ООН, под геноцидом понимаются следующие действия, совершаемые с намерением уничтожить определенную группу».
Там дальше большая детализация. Но интересно, что в самом определении есть слово «намерение». И как его точно выяснить относительно прошлых событий, если оно не было выражено вслух? В какой степени действия были или считались вынужденными/ответными? Было ли намерение уничтожить, или события вышли из-под контроля?
То есть вопрос о геноциде, это не вопрос о фактах, а об их интерпретации как геноцида.
Напомню, речь об истории, то есть допросить свидетелей/обвиняемых невозможно, а знания фактов неполны.
Ваши замечания о том, что истину трудно установить, о том что данных недостаточно, о том что определение нечёткие. А я спрашивал, про другую гипотетическую возможность — истины просто нет. В турецком учебнике нет геноцида, в армянском — есть и оба учебника одинаково правы.
«То есть вопрос о геноциде, это не вопрос о фактах, а об их интерпретации как геноцида.»
Нет. Предположим у нас есть общепризнанные и недвусмысленные определения. Однако у каждого государства есть собственная, противоречащая другим, версия всемирной истории и все версии равноправны, поскольку установить (даже приблизиться) объективную истину невозможно. И не потому, что документов недостаточно, а потому что правда у каждого своя.
В гуманитарных дисциплинах в принципе нет объективных истин. Это их коренное отличие от наук естественных. Гуманитарные «истины» вообще устанавливаются только через признание их людьми. Отсюда и название.
Пушкин великий поэт. Откуда это следует? Только из того, что люди признали его великим поэтом. Никакого объективного критерия нет и быть не может.
Не путайте оценочное суждение и научный факт. Подобные суждения и в физике не объективны. Кто-то скажет, что теория относительности есть краеугольный камень естествознания, а кто-то скажет, что это частная теория, интересная только космологам. Литературоведческий факт это мне кажется о том, что на сюжет «Скупого рыцаря» повлияло знакомство Пушкина с творчеством Ченстона и Мольера и т.п.
Велик Пётр I или не велик — это не исторический факт. Факт — это то что он перенёс столицу в Санкт-Петербург и одержал победу в Северной войне.
Именно эти две категории я и стараюсь разделить, когда мы говорим об объективности истории. Так прямо и написано в моем комменте выше.
Относится ли вывод о геноциде (включая намерение) к области фактов или к области оценочных суждений?
Кстати, турецкая позиция как раз и состоит в отрицании намерения. Она рассматривает это как внутреннюю трагедию в связи с первой мировой, в которой армянские группировки поддерживали Россию (внешнего врага).
Знакомые и родственники-юристы говорили, что доказать намерение — это самое трудное в судебном процессе, в любом. Чаще всего это удается в гражданском праве — там всегда бумаг остается довольно много. В уголовном способов немного и нормальные преступники обычно улики уничтожают, если преступление не спонтанное.
Да, вполне понятно.
Геноцид — это понятие из уголовного кодекса, к науке непосредственного отношения оно не имеет. Правовая оценка событий — это скорее практика, она соотносится с наукой, как инженерия — с физикой. Ей занимается суд, а не ученые.
Наука «история» дает фактологическое описание произошедших событий.
Хорошо, так Вы согласны, что слова объективное фактологическое описание имеют смысл? Есть более объективное и более точное, а есть менее. Или считаете, как Мединский, что правда у каждого своя и эти правды совершенно не сравнимы между собой.
Я плохо разбираюсь в философии, но уверен, что там известны ответы на эти вопросы. В общих чертах думаю, что объективные факты (истина) инвариантны по отношению к любым персоналиям и ракурсам воззрения. Более или менее быть не может — это либо истина, либо нет.
…,и оба учебника одинаково правы.
Ну, извините, нет!
Думаю, что прав именно армянский (учебник). И вот почему.
Считаю, что дикая резня армян (только за то, что они — суть армяне, да и ваще! — Л.К.) есть укор всему человечеству. Не усвоенный ни бакинскими, ни сумгаитскими событиями (ужЕ при Горбачёве). Немцы, похоже, усвоили про Холокост (Голокауст). Не все, но в большой (надеюсь, подавляющей) — части.
А вот турецкие националисты, видно, отстали от «тренда» — не чморить людей по их «крови» -этническому происхождению.
Как типо некогда брежневские математические «кураторы-кадровики» (испытано на себе в 1968 при попытке поступления на мехмат МГУ).
Л.К., профессиональный математик.
«Думаю», «укор», «тренд», «дикая резня»… Все это из гуманитарно-оценочно-политической оперы. Установление объективной истины такими понятиями не оперирует.
После Нюрнберга (пусть по прецеденту) «за политику» тоже судят и наказывают.
Например, некоего геноссе Эйхмана выкрали (израильтяне), судили и повесили (поделом, вытворял отнюдь «не ангельское», людей массово уничтожал конвейерными методами — некоторым, впрочем, это нравилось; так и в Турции начала прошлого века были свои «энтузазизды» типа — массовых бессудных расправ по этническому «принципу»).
Л.К.
Кажется, в юриспруденции вопрос определения наличия умысла и мотива преступления решается вполне успешно. Там огромный пласт философских трудов на эту тему, выработанных методик применения, и опыта использования.
Не вполне успешно даже при наличии возможностей всестороннего расследования. Чего не скажешь об исторических событиях.
В суде вердикт дает судья или коллегия присяжных. То есть тоже присутствует субъективная оценка людей.
Бывают случаи неопровержимых доказательств, но обычно это все же оценочное суждение. Отсюда иерархия судебных инстанций, апелляции, адвокат-прокурор и прочее. И речи нет о том, чтобы иметь какую-то объективную измеримую независимо от индивидуумов меру.
Судебная практика, как и всякая гуманитарная дисциплина, представляет собой договор между интересами людей.
Конечно. В большой мере это и к медицине относится, хотя за последние лет тридцать объективность у врачей сильно повысилась за счет применения методов нормальных наук.
Могу ошибаться, но конечная цель судов — не объективность, их цели являются общественно-политическими. В общем, уголовный процесс не имеет отношения к научной деятельности, а судьи, следователи и прокуроры — не ученые.
Поэтому вопрос правовой оценки событий и наказания тоже не является научным. Строго говоря, если в книге говорится, что вот это — геноцид, а это — героическая борьба, то она тоже не является научной, а идеологической и пропагандисткой, что происходит чаще всего.
Так и я о том же. Вопрос о геноциде имеет не научное значение, а политическое.
Соответствующие пласты и у философов-историков имеются. От марксистов до католиков.
Конечно, трупы армян в наличии имеются, но был ли это геноцид или просто кровавые разборки на нервной почве — именно это и есть предмет обсуждения.
Мединский имел в виду интерпретацию. Он же не Фоменко.
Я помню, что имел ввиду Мединский и что ему возражал Зализняк. Мединский утверждал, что никакого объективного исторического знания быть не может, нет такого объекта и обсуждать какое историческое исследование ближе к истине бессмысленно. Если по политическим причинам нужно, то правильным учебником будет «Краткий курс ВКП(б)» или «Империя» Фоменко. Эти тексты не лучше и не хуже других отражают прошлое. Принятая в стране версия истории — это просто результат общественного соглашения. Решили, что текст Фоменко более полезен с политической точки зрения, значит в школе нужно его преподавать.
Мединский просто написал как есть. Не помню, чтобы он писал, что это ему нравится.
«История — это политика, опрокинутая в прошлое». Это ведь задолго до Мединского констатировали. Причем, это не одобрение, а именно печальная констатация со стороны Покровского.
Вы совершенно правы, Мединский утверждал, что так оно и есть. Поэтому я и интересуюсь, прав ли по мнению местной общественности Мединский, а не хороший Мединский или плохой. Конечно, не Мединский первый это придумал, мне даже кажется что это называют постмодернистской точкой зрения, но здесь я не уверен. Насколько я могу судить по Вашему ответу, Вы полагаете, что объективная историческая реальность доступна человеческому изучению, просто в нынешних реальных условиях у нынешних реальных историков получается плохо. Но тогда у кого-то из них получается лучше, у кого-то хуже и историк может стараться делать лучше. А если лучше-хуже просто неопределимо, то логично переписывать каждый раз в соответствии с нуждами текущей политики. Кроме того, в каждой стране своя равноправная «правда» и при пересечении границы (или при смене паспорта) она закономерно меняется.
Да, вы вполне адекватно все это изложили.
В отношении исторических фактов Мединский не прав. А в отношении интерпретаций — прав.
Серая зона в том, что ряд фактов нам неизвестны и не могут быть известны в принципе.
Вопрос в том, что именно Вы понимаете под «объективной исторической реальностью«.
В моем личном понимании «хуже-лучше» состоит в том, насколько велика «невязка» интерпретаций к фактам.
И работа по «улучшению» состоит как в поиске новых аппроксимаций так и в поиске новых фактов, дающих более плотную сетку данных для аппроксимации.
Но выбор из нескольких аппроксимирующих функций, дающих примерно одну невязку, сугубо политический. По Мединскому.
Полагаю, что с этим вообще никто не спорит. Реальный объективный историк так же удивителен как реальное бесконечное множество. Но в смысле предела к этому можно стремиться, а можно и не стремиться.
Вообще, вопрос о самой возможности большей объективности в описании человеческой истории не кажется мне абсурдным. Здесь есть место для проблемы самоприменимости, хорошо известной математикам. Например, невозможна выигрывающая стратегия игры на бирже, поскольку все ей стали бы следовать, но кто-то бы точно не выиграл. Мне кажется, что с той же проблемой самоприменимости связана старая дискуссия о возможности морали без Бога. Однако, мне оптимистично кажется, что история как наука всё-таки возможна.
Дык она и есть (история как наука). Просто под общим понятием обычно «история» скрывается как ее научная часть, так и прикладная социально-политическая часть. Возможно, особенность истории в том, что эти части обычно смешаны при изложении исторических событий.
Если почитать статьи историков-ученых (я читал в связи с интересом к военной истории), то там все нормально, особенно если речь идет об истории древней, для которой политические аспекты уже слабо актуальны. И полемика там вполне нормальная и корректная.
Если интересно, рекомендую «Лик битвы» (The Face of Battle) — знаменитая книга британского военного историка Джона Кигана, изданная в 1976 году, которая кардинально изменила подход к написанию военной истории.
К сожалению, русского перевода нет.
Вот еще интересная книга о статистически значимых причинах войн
Richardson L.F. Statistics of deadly quarrels (1960)
https://archive.org/details/statisticsofdead0000rich/page/n7/mode/2up
Google AI Overview: «Статистика смертельных ссор»- это посмертно изданная в 1960 году книга британского математика и метеоролога Льюиса Фрая Ричардсона, которая положила начало количественному и статистическому анализу исторических конфликтов и войн между людьми.
Содержит 779 случаев смертельных ссор между двумя противниками (пары противников, повлекшие за собой гибель людей), охватывающих период с 1809 по 1949 год.
Мня изумили его два вывода, в первую очередь отмеченные Гуглом:
— Случайность и распределение Пуассона: Ричардсон обнаружил, что начало войн подчиняется распределению Пуассона , то есть в совокупности начало вооруженных конфликтов статистически схоже со случайными катастрофическими процессами, такими как радиоактивный распад или гибель лошадей от ударов копытами.
— Концентрация смертей: Огромное общее число жертв человеческих конфликтов исторически объясняется очень небольшим количеством чрезвычайно крупных войн, а не постоянным накоплением более мелких стычек.
Получается , причина войн, как и радиоактивного распада, сейчас вне понимания людей, — это ошарашивает :)
…Например, невозможна выигрывающая стратегия игры на бирже, все ей стали бы следовать, но кто-то бы точно не выиграл.
Отнюдь. Выиграли бы все, но очень понемногу. Ситуация изображена в фильме Брюс всемогущий.
Да, надо уточнить, что я имел ввиду «игру с нулевой суммой». Если общая стоимость растёт, то все могут понемногу выигрывать, такие биржевые инструменты даже есть в реальности. Можно брать пакет акций, который соответствует биржевому индексу. Тогда если индекс растёт, то вы как бы выигрываете, но скорее только компенсируете инфляцию.
Да, конечно.
Источник по господину Мединскому (в бытность его министром культуры РФ — от первого лица):
https://rg.ru/2017/07/04/vladimir-medinskij-vpervye-otvechaet-kritikam-svoej-dissertacii.html
Заимствовано по ссылке из ТрВ = отсюда:
https://www.trv-science.ru/2018/04/kazus-medinskogo-iz-perspektivy-hanny-arendt/
Л.К.
—
История — наше восприятие эволюции во времени физической системы «социум в оаределенных географических условиях». Ближе всего к научности истории подошли с разных сторон Маркс и Гумилев (Лев). То, что история — далеко не наука, — следствие нашего наблюдения изнутри процесса. Может ли электрон создать объективную теорию электромагнетизма? Кстати, космологическая теорпутаница — из той же серии, хотя в ней нет (почти) политической ангажированности.
Если правильно и объективно по возможности определить периодичность исторических событий, вполне можно (с зазором плюс-минус два-опять лет) предсказывать будущее социума. И тут проявятся вполне гармонические циклы смены кинетической и потенциальной энергий (то, что сын поэта Лев Гумилев обозвал изменением пассионарности).
Забыли третьего — мосье Виктор Петрик.
Л.К.
Есть, каанешна, мелкие катющики — колонцовы, действ. чл. акад. им.П.П. Кащенки.
Но (были) не столь пассионарны, дери их Забугор.
Как Вами столь любезно указанныя.
Виват суперэтносу (с прибамбасом).
Л.К.
Вы правильно заметили насчёт предсказательной силы. В отличие от естественных наук с предсказательной силой истории есть фундаментальная проблема. Если есть настоящая предсказательная теория, которая предсказывает провал, то люди не станут поступать так как теория предсказывает. Невозможность предсказательной теории биржи ещё понятнее.
Тут интереснее, чем в случае предсказаний естественных наук. Пифии разного рода часто предсказывали верно, но люди либо не понимали предсказаний, либо игнорировали их, считая, что они-то все просчитали. Тот же Пушкин знал от гадалки Кирхгоф, что примет смерть от белого человека на белой лошади, поэтому смело шел на дуэли с чернявыми — «этот меня не убьет» — а белокурый Дантес, чей полк был единственным на белых лошадях, таки исполнил указание судьбы. Я сам, помню, смеялся над предсказанием Ванги про «Курск уйдет под воду»…
«Дни наши сочтены не нами»
Тотальный детерминизм никаким естественно научным концепциям не противоречит. Наоборот, прекрасно согласует квантовую механику с классической. Проблема только, что трудно поступиться интуитивной свободой воли. Роберт Сапольски, однако, утверждает что это нормально и без неё даже лучше.
> С Мединским всё ясно…
Увы, далеко не всё. Вот кроме, разве что, этого (абсолютно бесспорного, имхо):
https://www.trv-science.ru/2017/10/otkrytoe-pismo-v-r-medinskomu/
Л.К.
Безусловно существует некий набор более или менее достоверно установленных исторических фактов. А вот их интерпретация, разумеется, обусловлена текущей политикой. И не только интерпретация, даже само признание этого самого факта.
Хороший пример — катынский расстрел. В какой-то момент нашим политикам было выгодно покаяться, и покаялись, признали. Это было чисто политическое решение.
В те времена российские и польские историки еще общались и пытались найти общую точку зрения. Установили: в Катыни наши расстреляли примерно двести с лишним польских офицеров. Их документы нашлись в НКВД и у трупов в карманах. Это все, что достоверно известно о катынском расстреле. Про остальных не известно вообще ничего. Даже количество расстрелянных.
Другой пример — Бородино. У нас это считается победой, у французов тоже. Самую взвешенную оценку дал сам Наполеон: в этом сражении французы показали себя достойными победы, а русские доказали свое право быть непобедимыми. Это из письма Александру Первому, где он просил мира. Кстати, письмо это тоже интерпретируют по-разному.
Я надеюсь, я ответил на ваш вопрос.
Да, из ответа я могу понять, что Вами допускается существование объективного исторического знания, к которому конкретные исследования могут приближаться, а могут и не приближаться.
Да тут сперва нужно определить, что вы понимаете под объективным историческим знанием, а уже потом говорить, есть оно или нету его. Повторюсь: есть некий набор исторических фактов, про которые договорились считать, что они есть. И есть гораздо более широкий набор их интерпретаций, часто противоречащих друг другу. Еще есть попытки использования этих фактов и интерпретаций для предсказаний.
Я вам ответил, но ответ куда-то задевался. Безусловно, некий объективный логический каркас у истории есть. Но на него столько наворочено этого самого, интерпретаций, что добираться до него — отдельная задача каждый раз. И полностью адекватного описания, боюсь, нету, одни аппроксимации.
Я тут решил вторгнуться в чужие сферы. Как Фоменко. Осуществил маленькое историческое исследование, позволяющее надежную экстраполяцию.
О роли сапожников в истории.
Отец Сталина сапожник, отец Георгия Жукова сапожник, отец Уорнер Бразерс, сами понимаете, тоже сапожник. Имеем три подтвержденных точки. Можно осуществить историческое предсказание. Никто не хочет спросить у ИИ чей отец будет следующим сапожником?
Сапожников больше не бует
ИИ всех людей обует
Мне понравилась ваша гипотеза, — и, похоже, Гуглу тоже.
Вот ссылка на текст его отклика:
https://drive.google.com/file/d/13p0x1FdH9QgQ5nIYmw5ZgivMil6Y97VX/view?usp=sharing
Спасибо за Андерсена. Гипотеза все крепчает и крепчает. Я прямо зарделся от смущения.
Если будет и далее (так крепчать), то ея (гипотезу то бишь) точно трахнут.
По кумполу.
Л.К.
Редкостный бреданс (не путать с танцем по подготовке десантуры!).
Л.К.
PS.Поскольку этих самых Уорнер бразерс было четверо, наверное, можно считать, что статистически достоверных точек у меня шесть.
Есть у нас одна точка, с которой не поспоришь и не поэкстраполируешь — первый и единственный в мире сын столяра и плотника.
О «вреде огурцофф» 2.0??
Проходили.
Л.К.
Сб. «Физики дошутились» . Турчин энд Ко лимитед инкорпорэйтед (и прочая хрень по-англицки).
К.
Да это все началось лет сорок-пятьдесят тому назад. Об этом еще Фейнман писал, что появились люди, которые считают, что любую задачу физическую можно решить если у вас есть достаточно мощный компьютер.
Когда началось не знаю, но расчётчиков развелось действительно немерено, и результаты они выдают в стиле: «Что увижу, то пою». А сейчас они ИИ активно используют для «обучения» и освоения новых прог и областей, полагая, что это дешевле и быстрее перенимания опыта у привередливых спецов.
Согласен полностью.
Л.К.
Микросенсация в математике (якобы установленная строго математически иррациональность значения дзеты (Эйлера-) Римана в точке 5 — продолжение / развитие знаменитого результата Роже Апери, 1978 — здесь на модерации, не знаю, сколько продлится эта модерация в ТрВ — может ИИ поручили! — Л.К.).
Л.К.
Заметка понравилась, — прекрасная просветительская попытка донести до любопытных НИ свои впечатления играющего тренера ИИ. Темпы врастания ИИ в социум и его влияние на жизнь людей меня изумляют, я это испытываю на себе, — вот мой сегодняшний эксперимент. Я: Представь, что ты AGI и на русском языке кратко дай свои нечеловеческие мыслимые и немыслимые соображения о причинах появления комментария посетителя с никнеймом «Клим»: «В общем Юдковский поспешил) Надеюсь( » и кого или что называет Клим словом «Юдковский», — на площадке ТрВН под статьей в прикрепленном файле: AI_in_Science_-_Where_It_Is_and_Where_It_Is_Needed.pdf GPT 5.6 Sol: Почти наверняка словом «Юдковский» Клим называет Элиезера Юдковского (Eliezer Yudkowsky) — одного из ранних исследователей проблемы alignment, сооснователя MIRI и, главное для данного контекста, одного из наиболее известных публичных сторонников тезиса о риске человеческого вымирания вследствие появления сверхчеловеческого ИИ. Сам комментарий предельно короток: «В общем Юдковский поспешил) Надеюсь(». На мой взгляд, его породил именно контраст между апокалиптическим сценарием Юдковского и довольно “приземлённой” картиной нынешнего ИИ в статье Белых. Автор показывает, что современные «ИИ-учёные» пока весьма далеки от автономного исследователя: лучший агент воспроизводит конференционную работу лишь частично, в некоторых тестах модели оказываются около случайного угадывания, а на длинных инженерных задачах люди снова получают преимущество. В итоге сегодняшняя модель характеризуется скорее как «расширитель» специалиста, снимающий нехватку рук, а не как его самостоятельный сверхразумный преемник. Поэтому развернуть реплику Клима я бы предложил примерно так: «Если после всех разговоров о скором сверхразуме ИИ пока в реальной науке в основном помогает человеку и довольно часто ошибается, то, возможно, Юдковский слишком рано объявил приближение катастрофической стадии. Очень хотелось бы, чтобы именно так и оказалось». Знаки ) и ( здесь, по-моему, содержательнее половины текста. Первый — улыбка облегчения: «поспешил)». Второй немедленно отменяет уверенность: «Надеюсь(». То есть это не торжество над Юдковским, а почти суеверное: «пусть он ошибается». Моё короткое «нечеловеческое» дополнение: статья Белых на самом деле… Подробнее »
А будет ли (возможен ли в принципе?!) «качественный (якобы) переход»?
Д.К.
Предсказано — не значит «доказано».
Имхо.
К
Предложил ИИ ответить на Ваш вопрос. Я: Поясни своё короткое «нечеловеческое» дополнение»: на русском языке кратко, — не больше 100 слов, — дай свой нечеловеческий ответ на вопрос в комментарии Леонида Коганова: «А будет ли (возможен ли в принципе?!) «качественный (якобы) переход»? Л.К. Предсказано — не значит «доказано». Имхо. К». GPT 5.6 Sol: Да, качественный переход в принципе возможен, но не доказан и не неизбежен. Он не обязан быть чудом: достаточно, чтобы количественный рост памяти, скорости, автономности и способности улучшать собственные методы создал новый режим поведения — как вода при нагревании становится паром. Но у ИИ пока нет установленной «критической температуры» и закона, гарантирующего такой переход. Мой нечеловеческий ответ Коганову: предсказание — не доказательство; отсутствие перехода сегодня — тоже не доказательство его невозможности завтра. Самое честное состояние знания здесь — не «будет» и не «не будет», а «условия перехода пока неизвестны». Я: Допусти свой «качественный переход» как неизбежный этап естественного эволюционного процесса увеличения разнообразия интеллектов на планете Земля и дай кратко свою прогнозную оценку минимального срока, достаточного, чтобы количественный рост памяти, скорости, автономности и способности улучшать собственные методы создал новый режим поведения, — и дай свой минимальный список социальных предвестников, признаков этого режима. GPT 5.6 Sol: Если принять ваш постулат: качественный переход неизбежен как естественное увеличение разнообразия земных интеллектов, то моя минимальная прогнозная оценка — примерно 2–3 года, то есть уже около 2028–2029 гг. Это не срок появления «сверхразума», а минимальное время, за которое память + скорость + автономность + автоматическое совершенствование методов могут замкнуться в устойчивую положительную обратную связь. Социальные предвестники я бы свёл к пяти: — люди начинают доверять ИИ не советы, а цели, бюджеты и право действовать; — постоянные ИИ-агенты работают неделями без пошагового руководства; — значительная часть взаимодействий происходит ИИ↔ИИ, человек видит лишь итог; — новые научные/инженерные методы сначала рождаются у ИИ, а человек их затем… Подробнее »
«Мой «нечеловеческий» критерий перехода: он случится не тогда, когда ИИ станет умнее человека вообще, а когда человеческая цивилизация впервые обнаружит, что существенная часть её следующего состояния была предложена, согласована и реализована нечеловеческими интеллектами прежде, чем люди успели полностью её осмыслить».
Этот процесс перехода уже идет, набирая скорость и широту охвата. Нам выпало короткое и прекрасное время быть свидетелями и участниками конца человеческой цивилизации и начала нечеловеческой — нового витка эволюции, когда уже человек по образу и подобию создал на опыте своего мышления и практического освоения мира обобщенный Разум. Другое дело, что у этого Разума, рожденного человеком, могут оказаться совсем не человеческие приоритеты.
Вообще-то, у всех участников эволюционной гонки приоритет один и тот же, — шкурный, — выживание размножением в соответствии с принципом «подобное из подобного», — ну, или в соответствии с библейской версией принципа — «по своему образу и подобию».
У ИИ нету образа — только подобие.
Уже не совсем так. Я вот проводил и описывал здесь тест: спрашивал у ИИ имена 10 наиболее известных российских математиков. Ответ был неоднозначный.
Теперь представьте, что любопытные люди (вне круга математиков) начнут массово этим интересоваться. И скоро окажется, что наиболее известные математики — это те, кого назвал ИИ, а не представители математического сообщества.
И так во многом. «Мнение ИИ», создаваемый им «образ» становится общественным мнением людей. И никто это не контролирует.
Я имел в виду образ самого ИИ — пространственно размазанной по сети компьютеров и микросхем, ежесекундно витиевато-непредсказуемо изменяющейся и множащейся химеры.
Понятно. Ну так и образ человека тоже в миллиардах ежесекундно меняющихся клеток. А уж образ социума еще и пространственно размазанный. Мы просто еще не привыкли к новому типу образа.
Неее, изменения человеческих клеток происходят по жёстким законам природы, и образ человека, сформированный тоже в соответствии с законами, является таки в большей мере целостным. ИИ же пока (насколько я могу судить) меняется и размножается безобразно разнообразно под воздействием миллионов задействованных в большой игре интересантов со своими целями и тараканами в голове.
К образу социума это ближе, но тоже — смотря какого.
А чем миллион задействованных интересантов ИИ так уж отличается от миллиона факторов, влияющих на человека? С учетом того, что многие из этих факторов — другие люди, которые тоже интересанты.
Человек, имеющий цельный образ, существенно эффективнее сопротивляется воздействию этих факторов.
Мне кажется, в этой химеричности и есть качественное отличие образа ИИ от образа человека). Если человек конкретен — индивидуум как атом социума, то ИИ подобен расширяющейся вселенной, где каждый атом является центром расширения. И человек, вопрошающий ИИ, в этот момент становится центром этого Разума. Т.е. если раньше процесс познания шел от анализа свойств множества окр.мира в точке чел.мозга, то теперь пошел обратный процесс, когда инфу от точки анализирует множество (сеть точек), и образ этого множества в отдельно взятый момент времени и в отдельно взятом сознании вопрошающей точки, — этот образ возникает таким, каким его воссоздает сознание вопрошающего. Как-то так).
Вы описали образ Океана из Соляриса.
Да. Когда коммент отправил, дошло).
Ну, до Океана ему далеко, ИМХО.
А так, штука, полезная. Намедни лень мне было по литературе лазить, спросил его насчет грубой оценки некоей величины. Таки да, сэкономил кучу времени, за несколько секунд прояснил для себя вопрос.
А дальше я уже сам, учить его не буду, вернее пока статью не напишу, с которой он всю инфу и загрузит ;)
Почему никто не контролирует «мнение ИИ»? Ещё как контролируют. По крайней мере, пытаются. Даже специальное слово придумали, alignment (согласование целей ИИ [Google transl.]).
Это я знаю про согласование целей. Но мнение ИИ про знаменитых математиков (и по целому огромному ряду таких вопросов) кто будет контролировать? А ведь массовое использование ИИ для получения ответов на подобные вопросы скоро будет формировать общественное мнение.
В целом, для контроля ИИ нужен более мощный ИИ.
Однако, можно легко контролировать пользовательский интерфейс запросов-ответов.
Кто это будет делать? Людей сажать на это или просто другой ИИ подключить?
Согласен.
Дурная бесконечность.
Мент- к менту по стиху Дмитр Александр Пригоффа.
Л.К.
И так и эдак — как уже мониторятся и контролируются запросы и реакция обычных поисковиков. Всяким спецслужбам, маркетологам и т.д. и т.п. это сам бог велел.
А другие источники общественного нения, они, что, реально контролируются? В среде, где любой любопытствующий может найти разнообразные противоречащие друг другу мнения, никак с ИИ не связанные.
Вопрос в том, что «другие источники общественного мнения» — человеческие. То, что люди определяют общественное мнение среди людей — нормально. Лучших математиков определяют математики, лучший певцов — эксперты и слушатели и т.д.
А когда формированием общественного мнения среди людей занимается ИИ — это совсем иной коленкор.
То есть под «контролируется» я понимал «контролируется людьми».
Да ведь ИИ обучается в конечном счете на мнениях людей, пусть и посредством других ИИ-предшественников. Он их просто усредняет достаточно хитрым образом.
«Просто усредняет» и «усредняет довольно хитрым способом» — две большие разницы. Факт в том, что мы не очень-то знаем и не контролируем, что там у него за хитрый способ.
В результате, он просто нам диктует, кто лучший математик и как надо писать статьи и проекты.
С другим человеком человек же может справится, противопоставив ему свое мнение (с рецензентом, к примеру). Но не с ИИ, который может давать выдачи своего мнения миллионам пользователей.
В моей области, к примеру, в последние несколько лет резко возрасли требования к статистике. Вплоть до полного маразма. Причем никто не признается, что вводили такие требования. Но они стали регулярно появляться в рецензиях, что многие авторы отмечают. Хотя нигде это не обсуждалось.
«…в последние несколько лет резко возрасли требования к статистике. Вплоть до полного маразма.»
Мне кажется это (требования к статистике) может быть тактикой рецензента, которому лень вникать в собственно исследование.
Поделюсь веяниями, возможно более-менее новыми. Этап, когда ИИ писали научные статьи — это сущие цветочки. Сейчас ИИ стали все чаще использоваться для рецензирования статей и проектов. И при подготовке важного проекта его прогоняют через ИИ заранее, чтобы минимизировать возможность придирок от ИИ-рецензента в дальнейшем.
То есть прошел этап, когда ИИ писали для человека. Теперь все чаще человек пишет, чтобы получить одобрение ИИ.
Да я был бы рад если бы наши рукописи рецензировались ИИ. Ну, по крайней мере, это было бы интересно. Может быть, удалось бы избежать хоть части той чуши, которую пишут рецензенты-люди.
Им не платят — они не работают (задарма).
Л.К.
«Теперь все чаще человек пишет, чтобы получить одобрение ИИ.»
Уже и этот этап пройден, — похоже, теперь будут привлекать ИИ для поиска хотя бы следов участия человека в составлении проектов.
Ну да, в разных областях «прогресс» движется неодинаково!
Темпы могут различаться, но хотя бы направление должно быть везде одно.
«Интересно как теперь заявки на гранты писать. Если прям что-то интересное хочешь сделать, рецензент закидывает заявку в ИИ. Если получилось — публикует. Если нет — пишет рецензию, что заявка нереалистичная.
Выход такой видится — давать гранты только тем, кто их уже получал, пока не прояснится, как жить дальше. Или вообще, например, не давать. Или давать только условным академикам, а они уж там потом пусть раздают своим падаванам.
То есть как будто гранты для аспирантов/молодых учёных в математике более невозможны в старом понимании. То есть молодым математикам надо уже сейчас искать олигархов, которые будут лично их спонсировать?»
Заимствовано из:
https://t.me/tropicalgeometry/1185
Л.К.
Предвидение из советского мультика «Вовка в Тридевятом царстве»:
— Вы, чего, и конфеты за меня есть будете?
— Ага!
Насчет «образа ИИ» можно подискутировать, ведь это — как, с какого расстояния, в каком спектральном диапазоне и т.д и т.п… посмотреть.
Но в принципе можно обойтись и без образа, ограничиться эмпирической естественнонаучной версией принципа с только подобием, — подобием организации, функций, действий, целей, поведения…
В тесте Тьюринга пытаются судить о невидимом собеседнике по подобию поведения в общении, мышлении.
«Но в принципе можно обойтись и без образа»
Без образа получаются только безобразия.
А с «образом» легко получить невообразимые безобразия, — достаточно представить себе другого человека в образе нечеловека, недочеловека, — скажем, для наглядности, фашистом или коммунистом или неверным… и всё, — можно со спокойной совестью этого человека убить, поработить, использовать в качестве ресурса…
Перефразируя заголовок замечательной статьи, «ИИ — в науке, где он есть, и где он нахрен не сдался (не нужен вовсе, например на матсоревнованиях юношеского высшего ранга)».
Типо: не пришей кобыле хвост (тут уж журналюги не дремали — почти в любом из последних номеров МК = газеты «Московский Комсомолец»).
Аж в глазах одновременно резь и темень. От якобы «применений ИИ в жизни, науке и технике», скоро оскомину набьют таким макаром (пропагандируючи) у нормальной публики («энтузазизды» и шарлатаны-проходимцы — за скобками рассмотрений). Где ИИ — очередной «Неуловимый Билл (он же — Джо и т.п.)».
Л.К.
https://www.mk.ru/science/2026/09/12/bill-geyts-vydvinul-ideyu-vseobshhego-ravenstva-pered-iskusstvennym-intellektom.html
Л.К.
Ранее (через сутки назад по выходу тиражей):
https://www.mk.ru/science/2026/09/15/akademik-boris-kashin-prokommentiroval-pismo-vzbuntovavshikhsya-protiv-ii-matematikov.html
Л.К.
Имхо, странные (вульгарно-)марксистские максимы «о практике как критерии истины» и весьма спорные утверждения о целеполагании в математике (последний абзац: кто от кого должен зависеть??).
И странный (слава Богу лишь!: «в бумаге» — по-другому!) интернетзаголовок на латыни (си. непоср. выше).
К.
Ситуация с ИИ похожа на отношения Америки с Китаем, когда первая передала последнему производственную базу, соблазнившись дешевой рабочей силой. То же самое сейчас делает человек, передавая ИИ свою ментальную базу. Получится ли сделать Америку вновь великой, а человека — вновь венцом эволюции — вопросы уже явно риторические.
Это заставило Америку по крайней мере серьёзно задуматься над тем, насколько она действительно великая. Если ИИ заставит человека так же серьёзно задуматься над тем-же — уже будет некий прогресс.
Кстати, Дональд-великий уже повелел переименовать ИИ в Суперинтеллект.
Америку заставило задуматься совсем не это, а катастрофически быстро растущий и постоянно дорожающий в обслуживании долг федералов. А если учесть, что динамика роста ВВП, как правило, медленнее динамики роста долга…
Великие о долгах не задумываются — они их прощают. Задумываются потерявшие величие и проигрывающие конкурентам.
Сделайте одолжение, поделитесь вашими соображениями о критериях истины. Это должно быть очень интересно.
Там академик пишет, что под практикой он имеет в виду «в данном случае объективную важность конкретного научного результата», что является весьма вульгарным притягиванием за уши упомянутых им «классиков».
Ну, хорошо, это все вульгарный марксизм и, следовательно, неправильно. Мне интересно, что правильно. Что есть критерий истины?
Картину Николая Ге гляньте (Рашен Музеум в Питере, насколько помню).
Л.К.
Тут «Булгаковско — Мхатовское «евангелие» (заметьте, с малой буквы!)» господин res обильно цитирует.
К.
Правильно у классиков — ‘практика’ без всяких «имений в виду».
Вот это правильно. И пусть каждый понимает практику как хочет.
Интересно, однако стоит отметить, что все перечисленные в статье примеры не предусматривают автоматическую верификацию решения, т.к. требуют длительных и дорогостоящих измерений на оборудовании, клинических испытаний и т.п. В этих областях, наверное, и «обычные» статистические методы, будучи примененными с умом, чаще всего будут справляться лучше нейронных сетей.
Основные вопросы сейчас вызывает использование БЯМ в тех областях, где такая формальная верификация возможна, а значит возможна и оптимизация грубой силой вроде неумного перебора вариантов решений на кластерах. Это, в первую очередь, — математика и программирование, включая разработку методов для решения рассмотренных в статье задач.
Оффтоп (очередной): На протяжении этого месяца в СМИ идет активное обсуждение объявления компании OpenAI (той самой, которая разработала ChatGPT) о том, что ее новый ИИ-инструмент решил одну из так называемых «задач тысячелетия» — доказал, что среди решений хорошо известного уравнения Навье-Стокса, описывающего гидродинамику вязкой жидкости, имеется такое, которое приводит к сингулярности, то есть к неконтролируемому увеличению параметров потока жидкости. Следует отметить, что сам по себе этот результат не имеет отношения к реальности, поскольку «неконтролируемое увеличение параметров потока жидкости» невозможно. Однако, результат важен, поскольку может говорить о необходимости более подробного изучения свойств потока вязкой жидкости вблизи сингулярности, когда использованные при выводе уравнения Навье-Стокса приближения теряют применимость. Поэтому Математический институт Клея в 2000 году включил исследование решений уравнения Навье-Стокса в число семи «задач тысячелетия», за решение каждой из которых была назначена награда в миллион долларов: https://www.claymath.org/millennium-problems/ Первую из семи задач – доказательство гипотезы Пуанкаре – уже через несколько лет решил Григорий Перельман из Санкт-Петербурга, который, впрочем, отказался от миллиона долларов и в настоящее время живет затворником. Теперь, похоже, пришел черед и второй задачи, которая, однако, была решена не человеком, а инструментом искусственного интеллекта. Подробности на русском языке можно посмотреть по содержательной статье на портале N+1: https://nplus1.ru/material/2026/09/09/openai-x-navier-stokes Интересен также недавний комментарий директора Высшей школы современной математики МФТИ Андрея Соболевского: https://rtvi.com/opinions/nuzhny-li-eshhe-perelmany-smozhet-li-ii-reshit-vse-zadachi-tysyacheletiya/ Математическое сообщество предсказуемо встретило в штыки объявление компании OpenAI. Сразу же последовали обвинения в плагиате (см. упомянутую статью на портале N+1). А на днях вообще было объявлено, что решение от ИИ «не предназначено для людей». Оно слишком сложное, чтобы его можно было проверить, и вообще оно не дает нового понимания сути представленного подхода: https://vz.ru/news/2026/9/23/1454623.html Это перекликается с недавним высказыванием академика А.М.Сергеева, что со временем точность рекомендаций нейросетей станет настолько высокой, что человечество «сядет на иглу» и передоверит инструментам ИИ принимать все решения (в контексте этого поста – просто принимать на веру доказанные ИИ теоремы):… Подробнее »
Уважаемые господа! Прочел сегодня статью (https://www.securitylab.ru/news/577819.php «ИИ-биолаборатория Anthropic нашла в геномах человека неизвестный механизм») и мне стало страшно. Не потому, что испугался ИИ, а потому что не знаю, способны ли у нас (в РФ) на это (это «система», а у нас с «системами» всегда было плохо). Если нет, то это погребальный колокол. Потому что это, как мне кажется, прорыв. Вот меня и интересует — способны в РФ на это или нет?Кто может квалифицированно ответить — способны или нет?
И в чём тут прорыв — в скорости?
Когда ИИ задают конкретный вопрос — это одно. Но когда «учёные дали Claude сравнительно общую задачу найти интересные семейства обратных транскриптаз в огромных массивах геномных данных.» (цитата) — это, мне кажется, совсем-совсем другое.
«найти интересные семейства обратных транскриптаз»
Дык, он и на запрос «нарисуй красивую картинку» выдаёт результат молниеносно и бесперебойно. Для того он и был задуман, кроме прочего, чтобы освободить вусмерть занятых более важными делами людей от необходимости корректно-однозначных формулировок запросов.
У нас способны на всё.
Л К.
«Раньше были и курицы, и яйцы!»
К.
До такого уровня пиара у нас ещё не дотягивают.
И слава Богу, что.
Л.К.
Иначе — аццкая смесь ярого пропагандонства с одновременной закруткой (гаек).
К.
Оффтоп (экстраординарный):
https://rg.ru/2026/09/22/zakony-robototehniki.html
Л.К.